AI 반도체 패키지는 왜 휘어질까? 워페이지가 수율을 좌우하는 이유
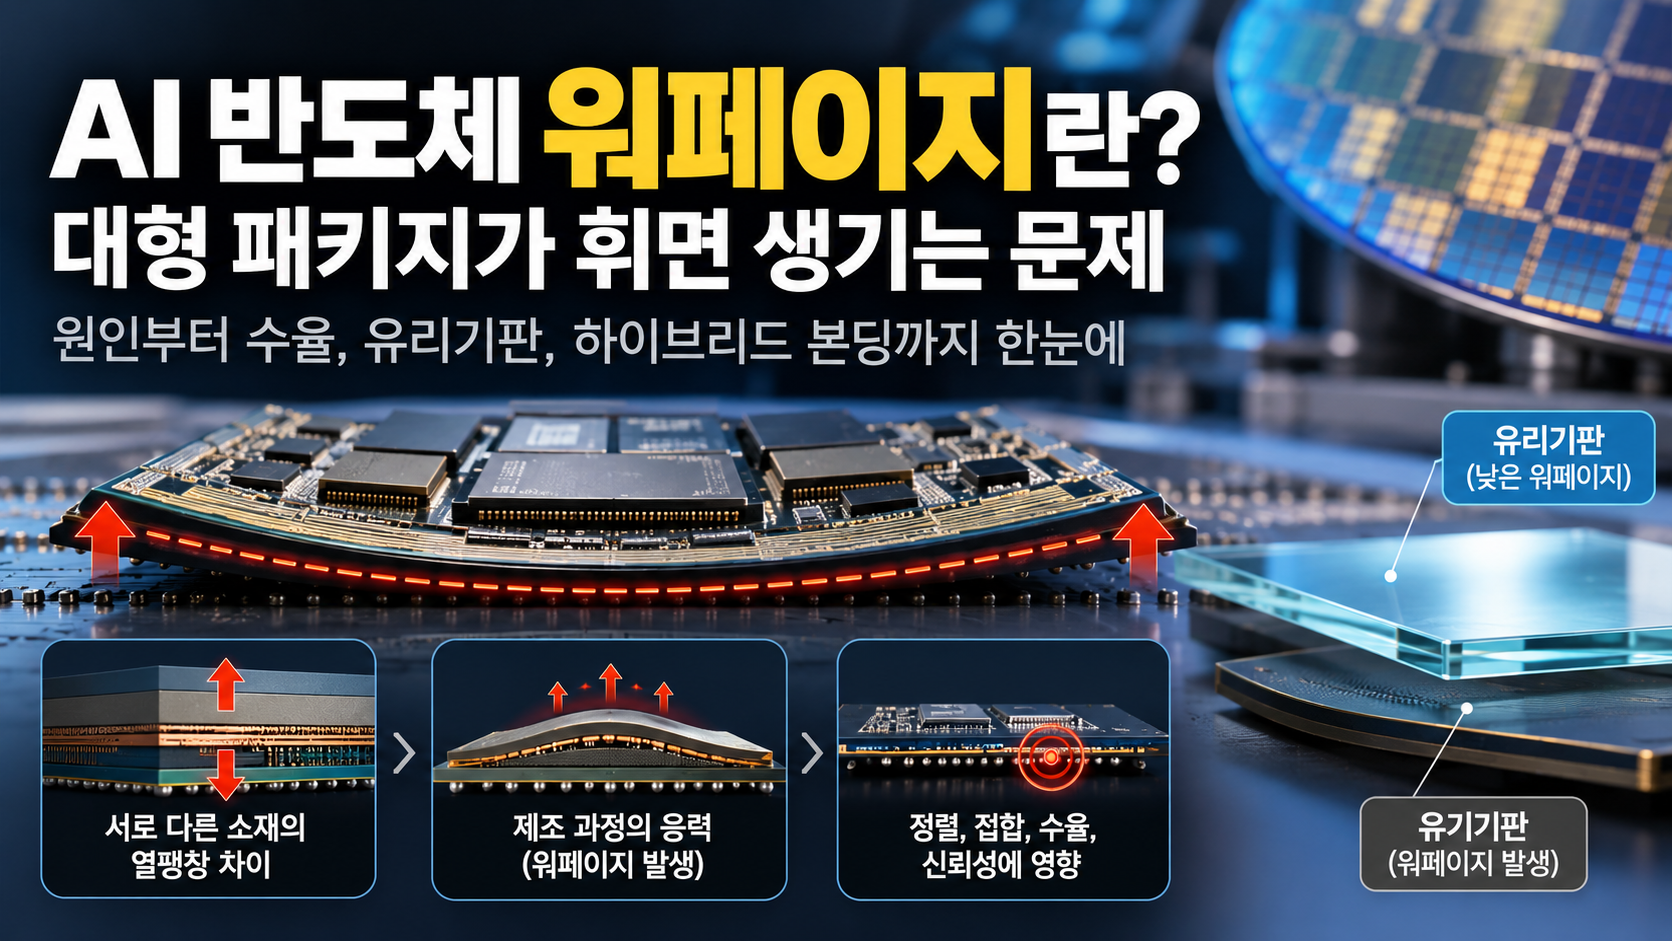
AI 반도체 워페이지와 대형 패키지 휨, 유리기판의 워페이지 감소를 설명하는 이미지

AI 반도체 워페이지는 첨단 패키지가 대형화되면서 함께 주목해야 할 제조 문제다. GPU나 AI ASIC 하나만 넣는 것이 아니라 여러 개의 컴퓨트 다이와 HBM, 인터포저, 패키지기판을 하나의 시스템처럼 연결하면서 패키지의 크기와 구조적 복잡성이 커지고 있기 때문이다. 이 과정에서 완성된 패키지가 평평하게 유지되지 않고 휘어지는 현상을 워페이지(Warpage)라고 한다. 워페이지는 단순히 반도체의 모양이 조금 휘는 문제가 아니다. 첨단 … 더 읽기
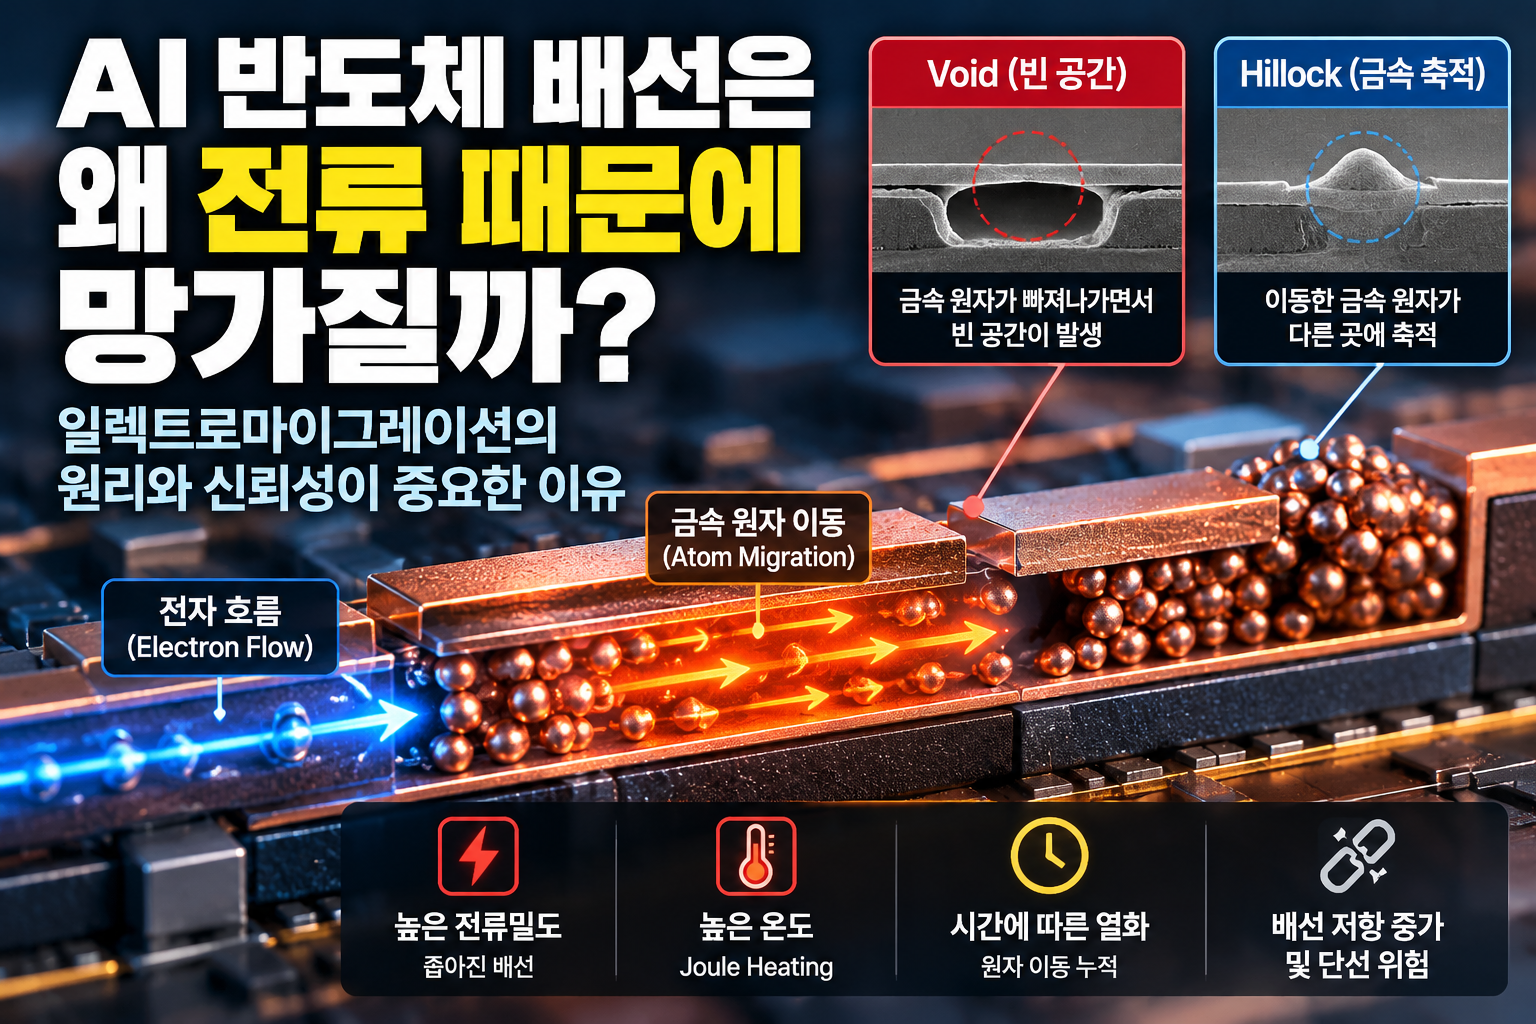
일렉트로마이그레이션이란?|AI 반도체 배선이 전류 때문에 망가지는 이유

반도체 일렉트로마이그레이션으로 금속 원자가 이동해 배선에 Void와 Hillock이 발생하는 원리

**반도체 일렉트로마이그레이션(Electromigration·EM)**은 미세한 금속 배선에 높은 전류밀도가 지속될 때 금속 원자의 이동이 누적되면서 배선의 신뢰성을 떨어뜨리는 현상이다. 반도체 안의 금속 배선은 단단하게 고정돼 있는 것처럼 보인다. 구리 배선에 전류를 흘려보낸다고 해서 금속 자체가 움직일 것이라고 생각하기는 어렵다. 하지만 나노미터 크기의 좁은 배선에 높은 전류밀도가 오랜 시간 유지되면 이야기가 달라진다. 금속 원자의 이동이 누적될 수 있기 … 더 읽기

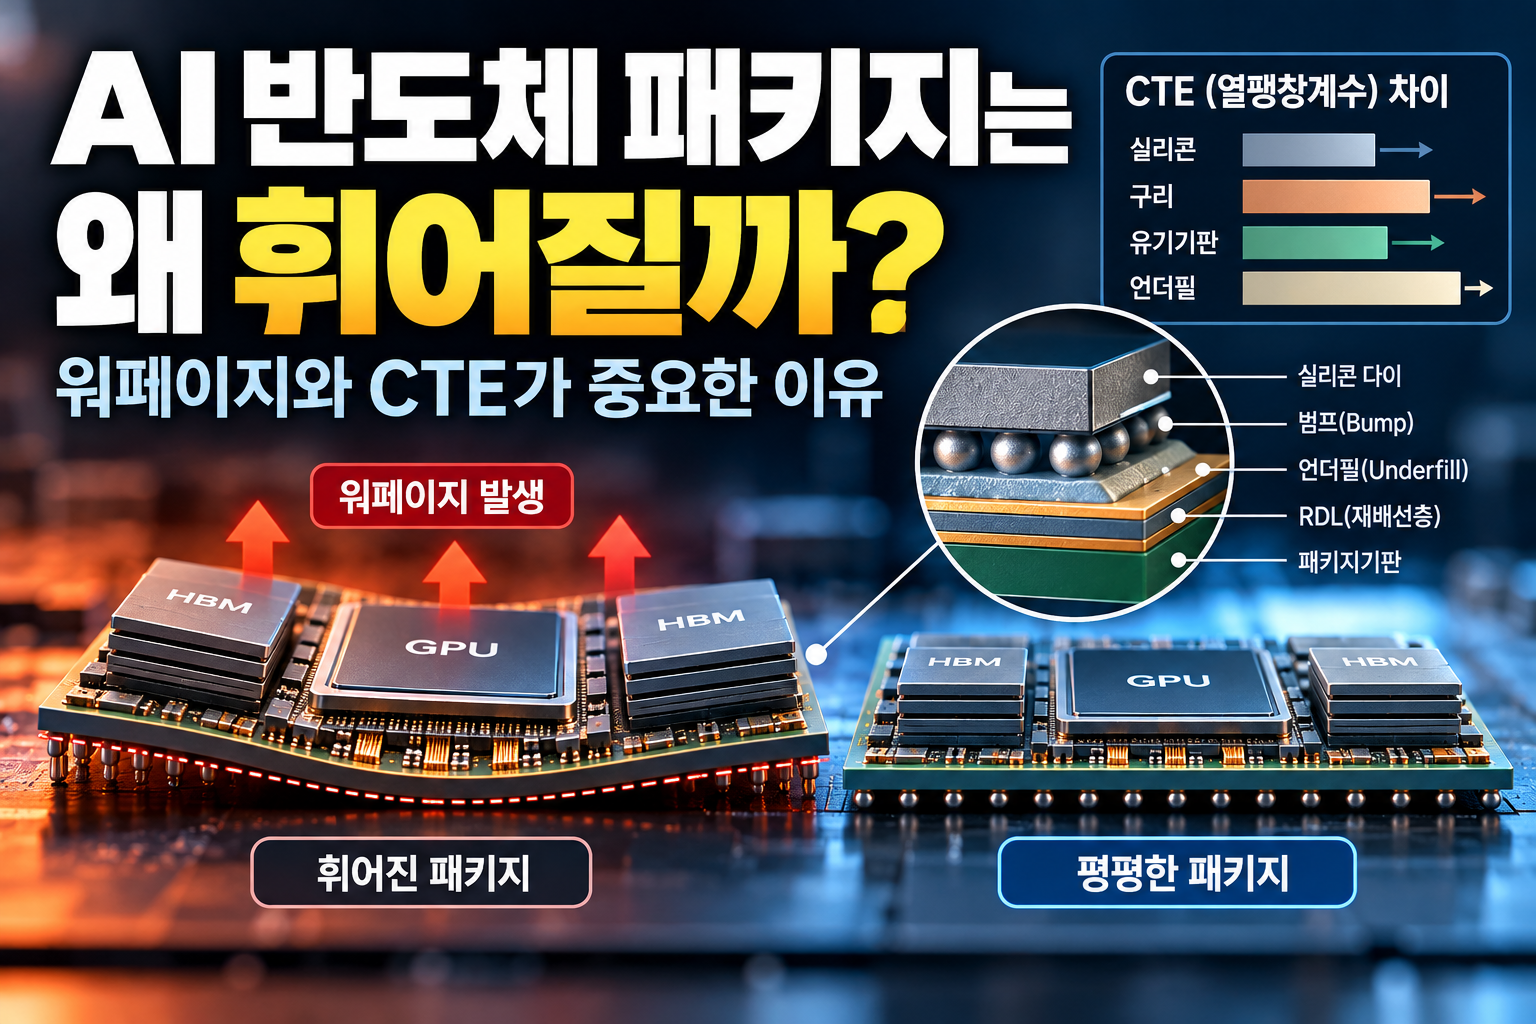
AI 반도체 패키지는 왜 휘어질까|워페이지와 CTE가 중요한 이유

AI 반도체 패키지 워페이지와 CTE 차이로 인한 GPU HBM 패키지 휨 구조

**AI 반도체 패키지 워페이지(Warpage)**가 첨단 패키징에서 중요한 기술 문제로 떠오르고 있다. AI 반도체 경쟁을 보면 흥미로운 변화가 하나 있다. 트랜지스터는 계속 작아지는데 반도체 패키지는 오히려 커지고 있다. 하나의 GPU나 AI 가속기 주변에 여러 개의 HBM을 배치하고, 여러 컴퓨트 다이와 I/O 다이를 하나의 패키지에 집적하면서 전체 시스템의 크기가 커지고 있기 때문이다. Intel Foundry 역시 AI가 단일 … 더 읽기

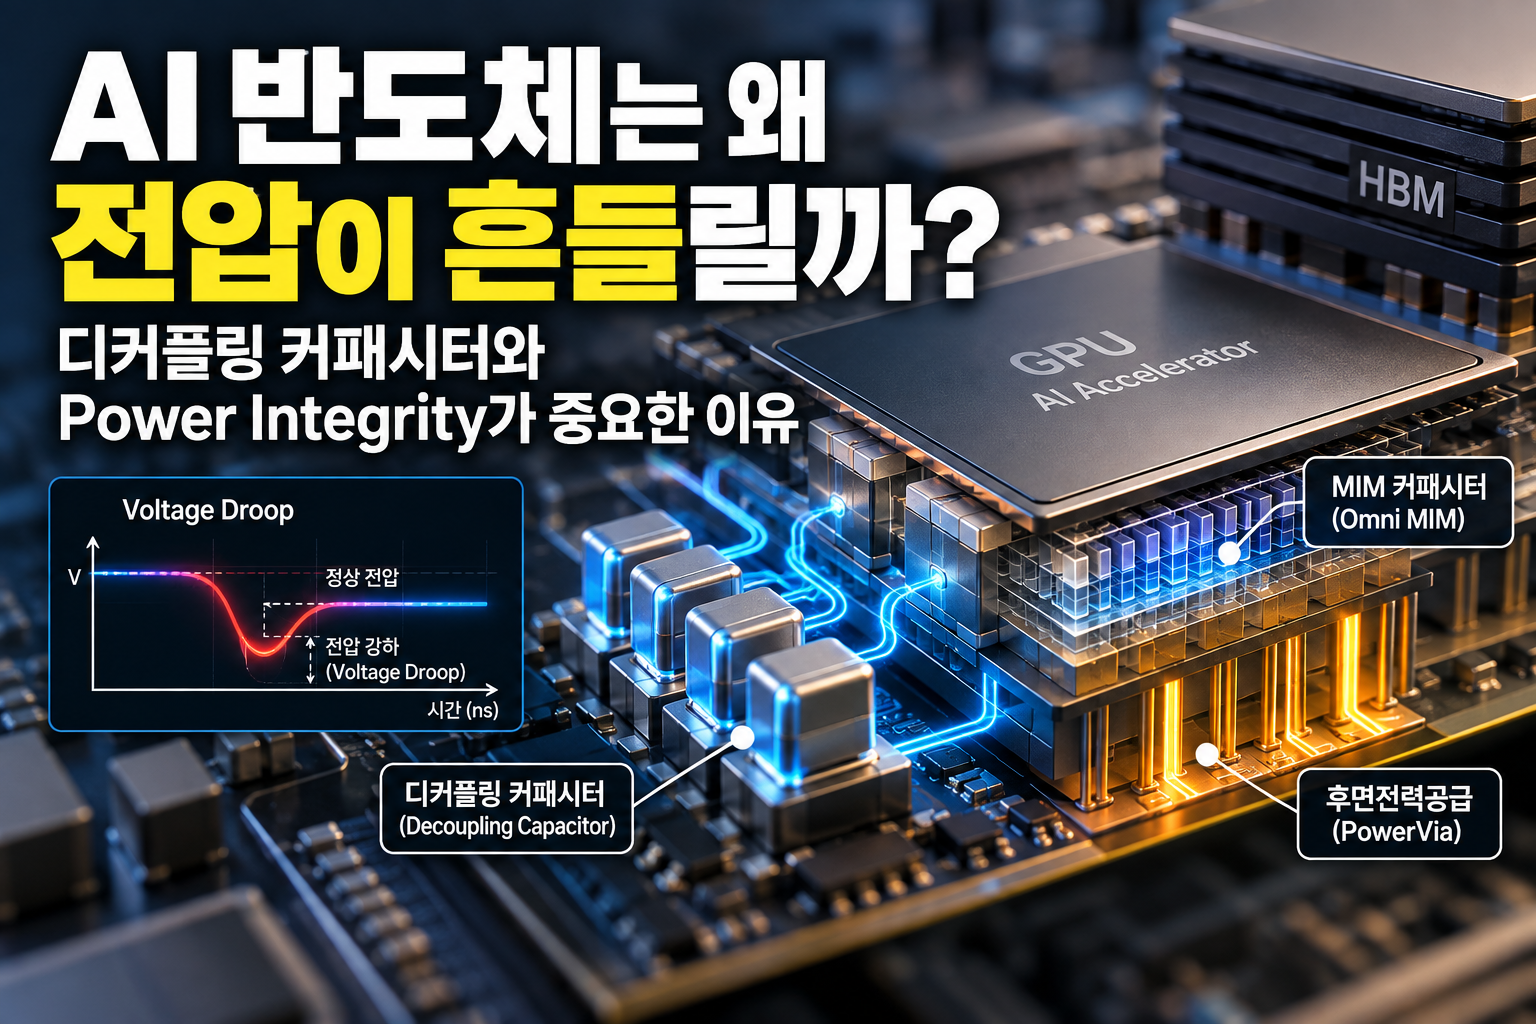
AI 반도체는 왜 전압이 흔들릴까|디커플링 커패시터와 Power Integrity가 중요한 이유

AI 반도체 전력 무결성과 Voltage Droop, 디커플링 커패시터 및 후면전력공급 구조

**AI 반도체 전력 무결성(Power Integrity)**이 차세대 GPU와 AI 가속기의 중요한 설계 과제로 떠오르고 있다. AI 반도체의 성능을 이야기할 때 우리는 보통 연산 성능과 HBM 대역폭을 먼저 본다. 몇 개의 GPU를 연결했는지, HBM을 얼마나 탑재했는지, 몇 나노 공정으로 만들었는지가 주요 비교 기준이다. 하지만 아무리 빠른 GPU를 만들어도 칩 내부에 공급되는 전압이 순간적으로 흔들린다면 높은 성능을 안정적으로 … 더 읽기

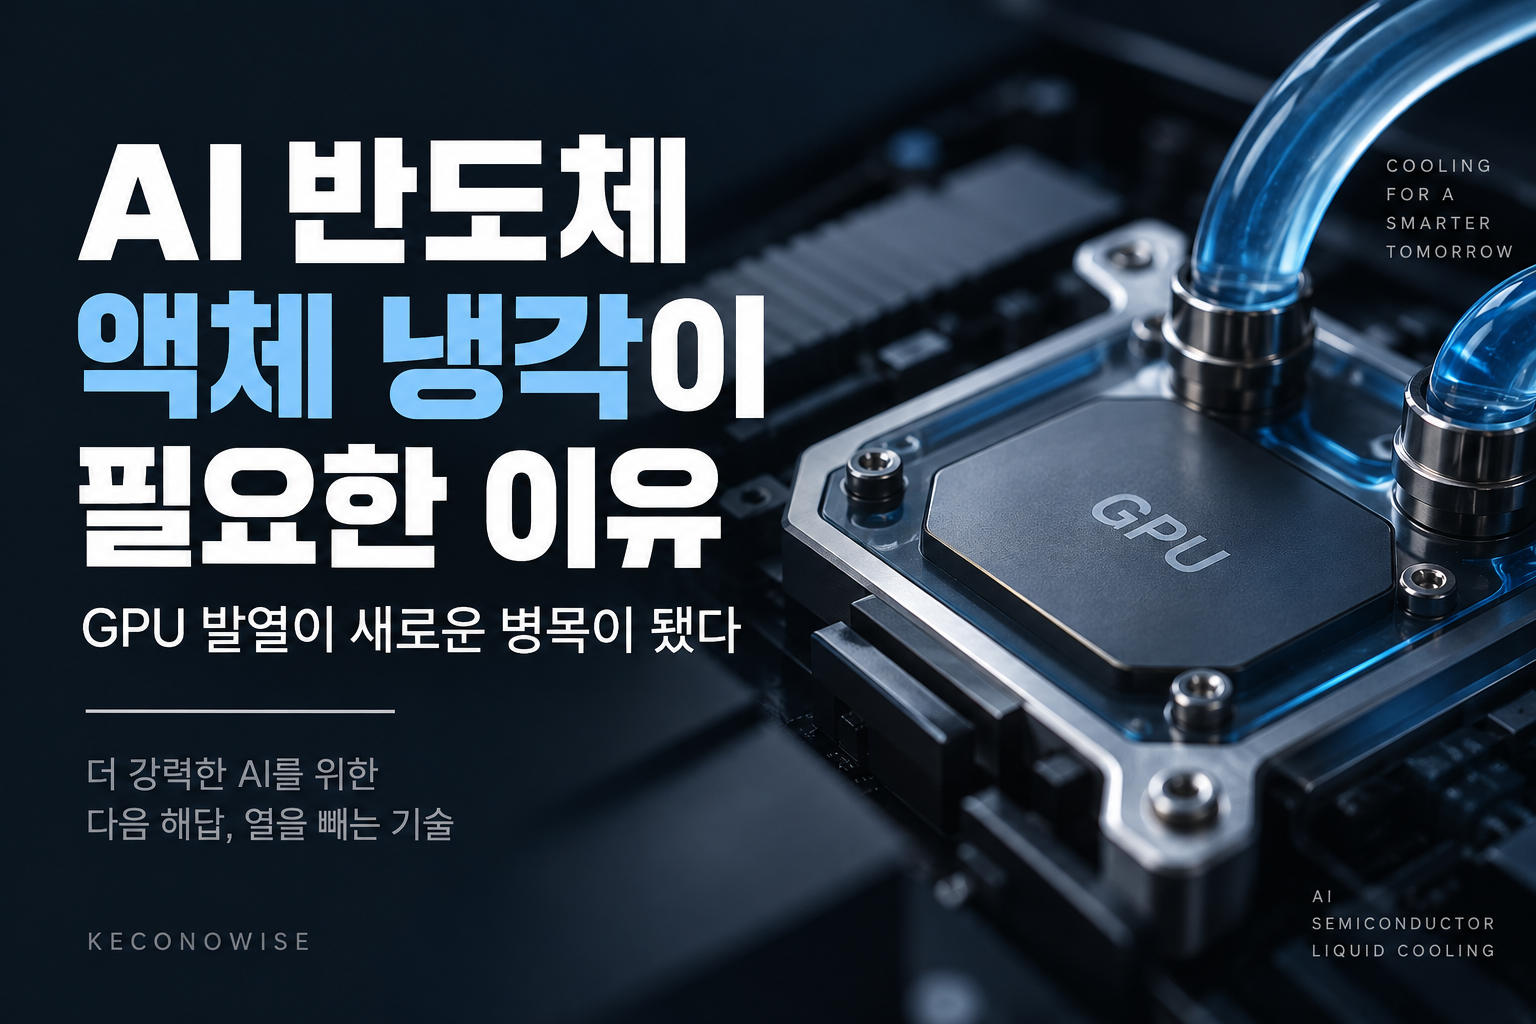
AI 반도체 액체 냉각이 필요한 이유|GPU 발열이 새로운 병목이 됐다

AI 반도체 액체 냉각과 GPU 발열 병목을 보여주는 데이터센터 GPU 냉각 시스템

AI 반도체 액체 냉각이 차세대 AI 데이터센터의 핵심 기술로 떠오르고 있다. AI 반도체 경쟁을 이야기할 때 우리는 주로 GPU의 연산 성능을 본다. 몇 개의 GPU를 연결했는지, HBM을 얼마나 탑재했는지, 메모리 대역폭이 얼마나 넓어졌는지가 새로운 제품의 성능을 설명하는 핵심 숫자로 사용된다. 그런데 AI GPU의 성능이 빠르게 높아지면서 이전에는 상대적으로 주목받지 않았던 문제가 새로운 병목으로 떠오르고 있다. … 더 읽기

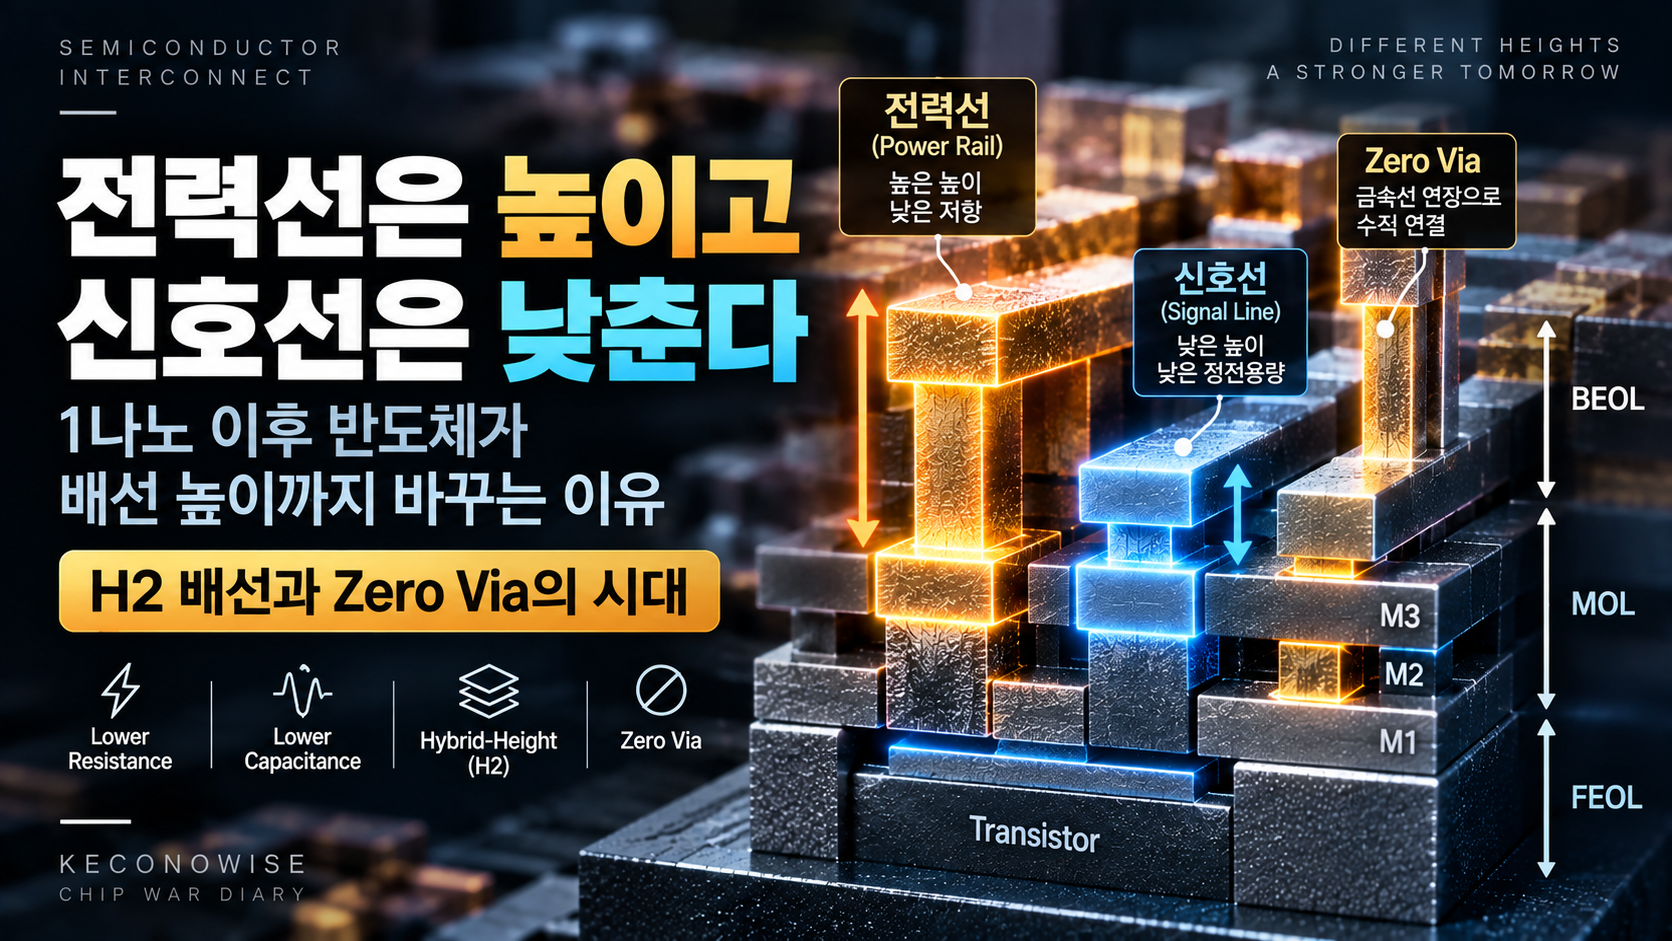
전력선은 높이고 신호선은 낮춘다 — 1나노 이후 반도체 배선이 달라지는 이유

1나노 이후 반도체 H2 배선의 전력선과 신호선 높이 차이 및 Zero Via 구조

반도체 안에는 수많은 금속 배선이 있다. 그런데 이 금속선들은 모두 같은 일을 하지 않는다. 어떤 배선은 트랜지스터에 전력을 공급하고, 어떤 배선은 트랜지스터 사이에서 신호를 전달한다. 역할이 다른데도 지금까지 하나의 금속층 안에서는 기본적으로 비슷한 높이의 배선을 만드는 방식이 사용돼 왔다. 하지만 반도체 미세화가 1나노 이후를 향하면서 이 당연해 보였던 전제까지 바뀔 수 있다. 전력선은 더 높게 … 더 읽기

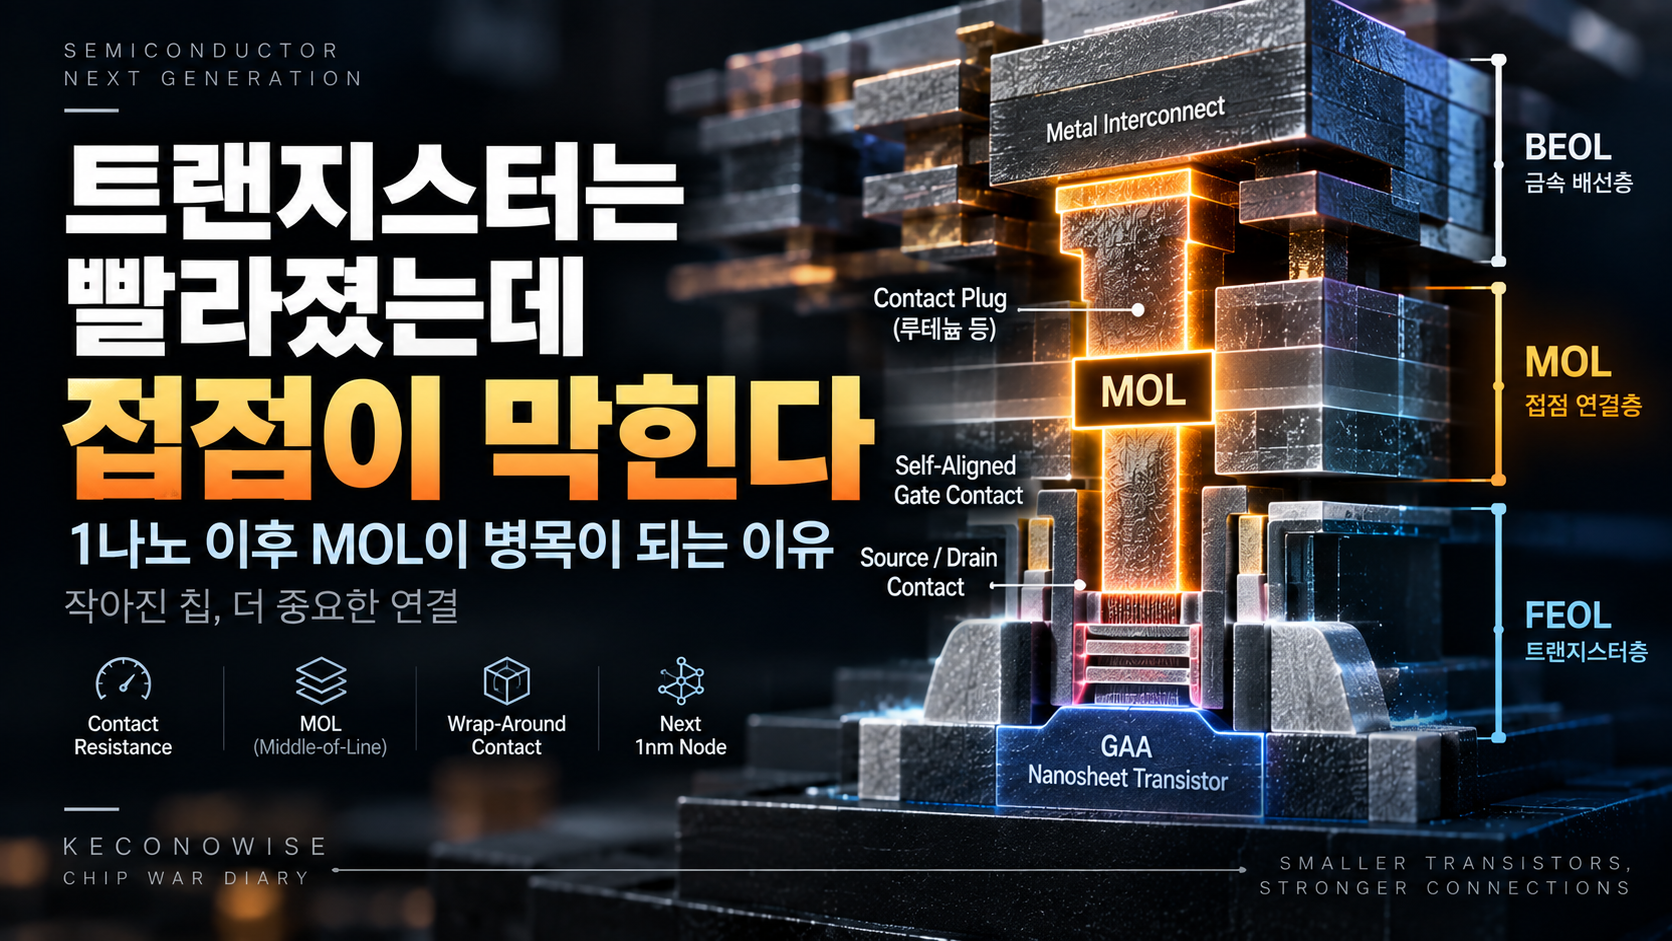
트랜지스터는 빨라졌는데 접점이 막힌다 — 1나노 이후 MOL이 병목이 되는 이유

1나노 이후 반도체 MOL과 콘택트 저항 병목을 설명하는 FEOL MOL BEOL 구조 이미지

반도체 미세공정 경쟁은 오랫동안 트랜지스터를 얼마나 작게 만들 수 있느냐의 싸움이었다. FinFET에서 GAA로 구조가 바뀌고, 더 작은 공정으로 이동하면서 같은 면적에 더 많은 트랜지스터를 집어넣는 것이 반도체 발전의 핵심처럼 보였다. 하지만 트랜지스터를 작게 만드는 것만으로 칩이 계속 빨라지는 것은 아니다. 트랜지스터에서 만들어진 전기 신호는 결국 금속 배선으로 전달돼야 한다. 그런데 트랜지스터와 금속 배선 사이에는 우리가 … 더 읽기

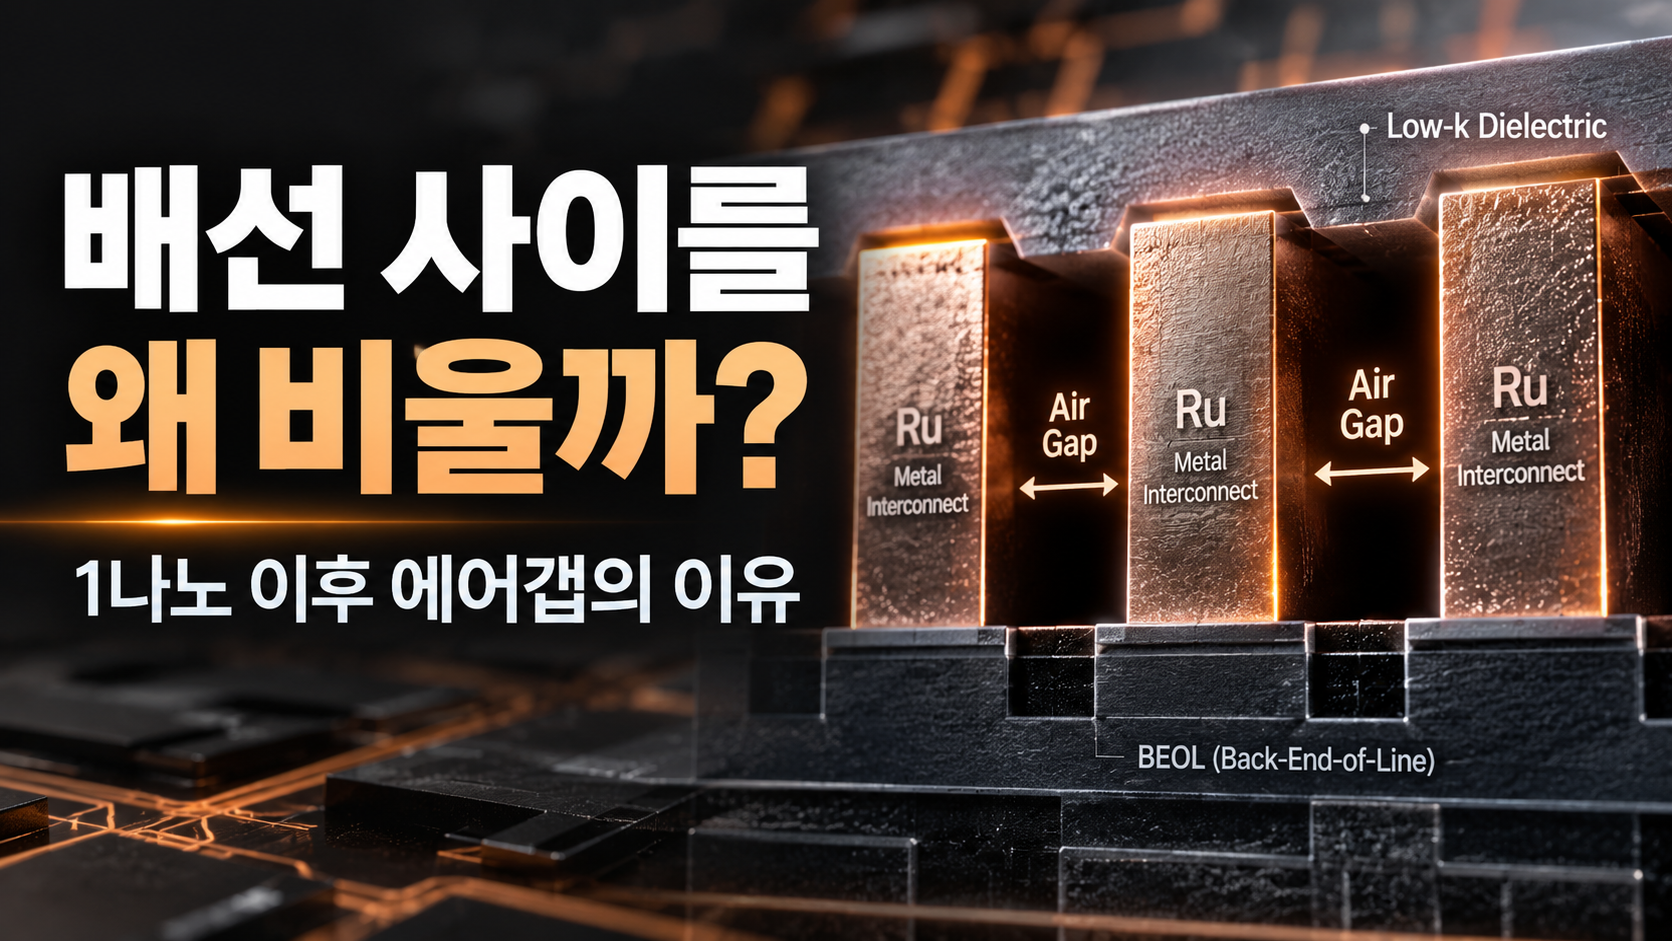
배선 사이를 왜 비울까 — 1나노 이후 반도체 에어갭이 필요한 이유

1나노 이후 반도체 에어갭과 루테늄 금속 배선 구조를 보여주는 이미지

반도체 미세공정 경쟁을 이야기할 때 우리는 주로 트랜지스터를 본다. FinFET에서 GAA로 구조를 바꾸고, 더 작은 공정으로 이동하면서 같은 면적에 더 많은 트랜지스터를 집어넣는 것이 반도체 발전의 핵심처럼 보인다. 하지만 트랜지스터를 아무리 빠르게 만들어도 그것들을 연결하는 금속 배선이 느려지면 칩 전체의 성능은 같은 속도로 높아질 수 없다. Keconowise에서는 앞서 구리가 2나노 아래에서 왜 한계에 부딪히고 루테늄(Ru)이 … 더 읽기

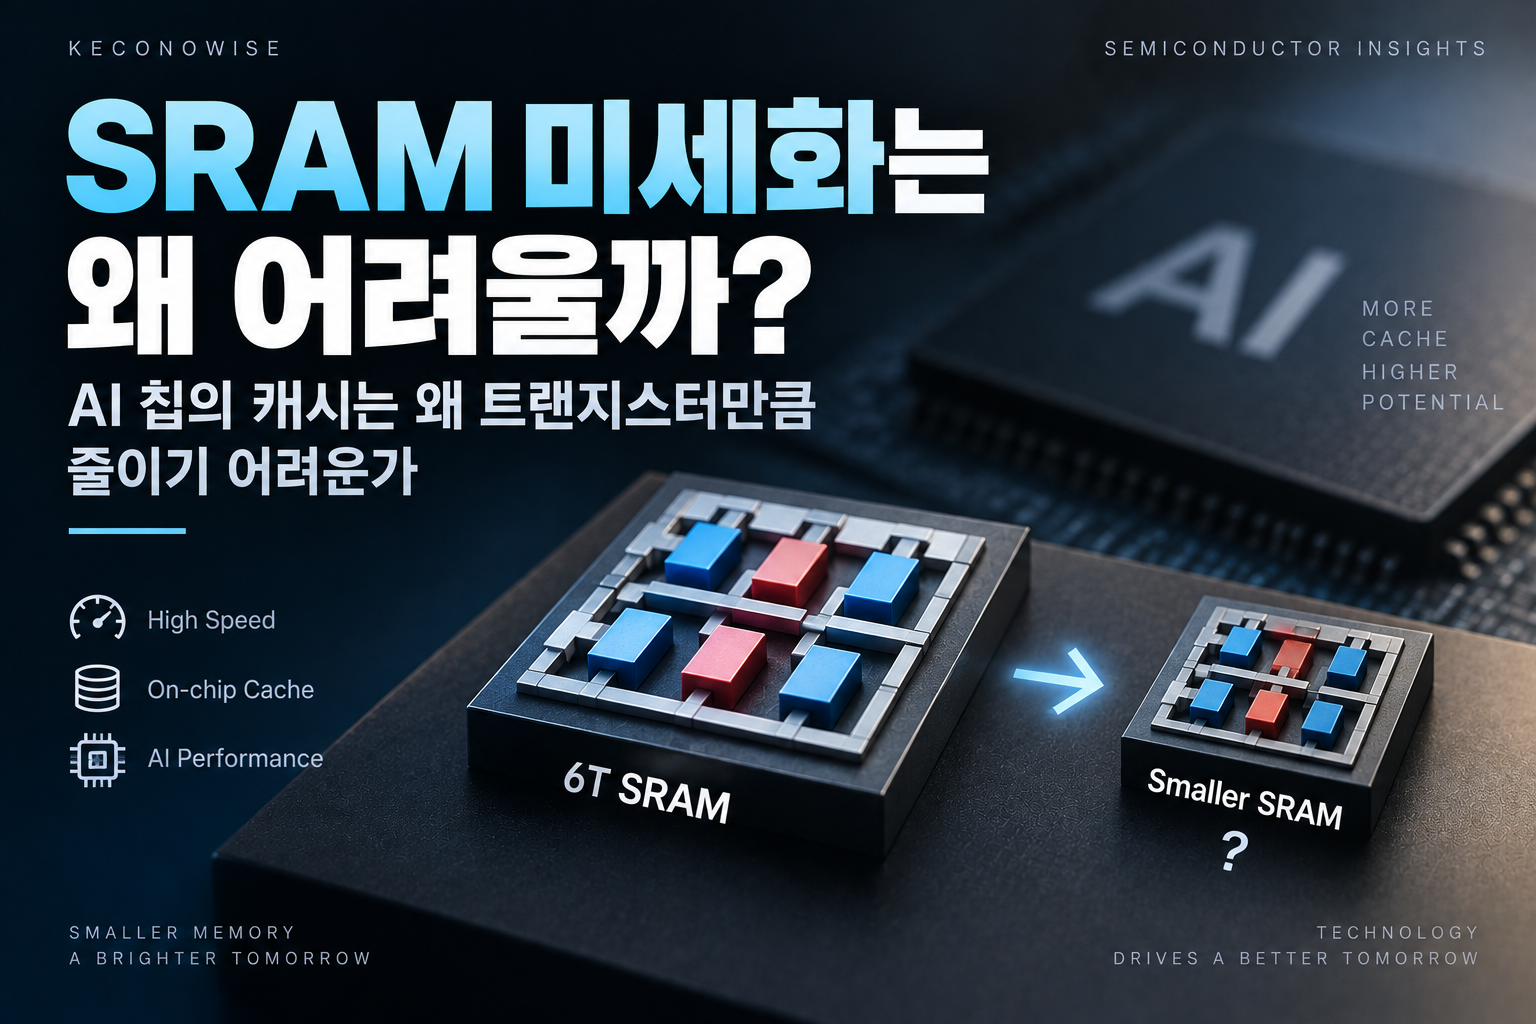
SRAM 미세화는 왜 어려울까? AI 칩의 캐시는 왜 트랜지스터만큼 줄이기 어려운가

6T SRAM 구조와 차세대 SRAM 미세화를 비교한 AI 칩 캐시 구조

반도체 미세공정을 이야기할 때 가장 먼저 등장하는 것은 트랜지스터다. FinFET에서 GAA 나노시트로. GAA에서 Forksheet로. 그리고 앞으로는 nMOS와 pMOS를 위아래로 쌓는 CFET까지 연구되고 있다. 트랜지스터는 계속 작아지고 있다. 그렇다면 CPU와 GPU 안에 있는 메모리도 같은 속도로 작아질 수 있을까. 여기서 문제가 시작된다. 대표적인 것이 SRAM(Static Random Access Memory) 미세화다. SRAM은 CPU와 GPU, AI 가속기 내부에서 캐시와 … 더 읽기

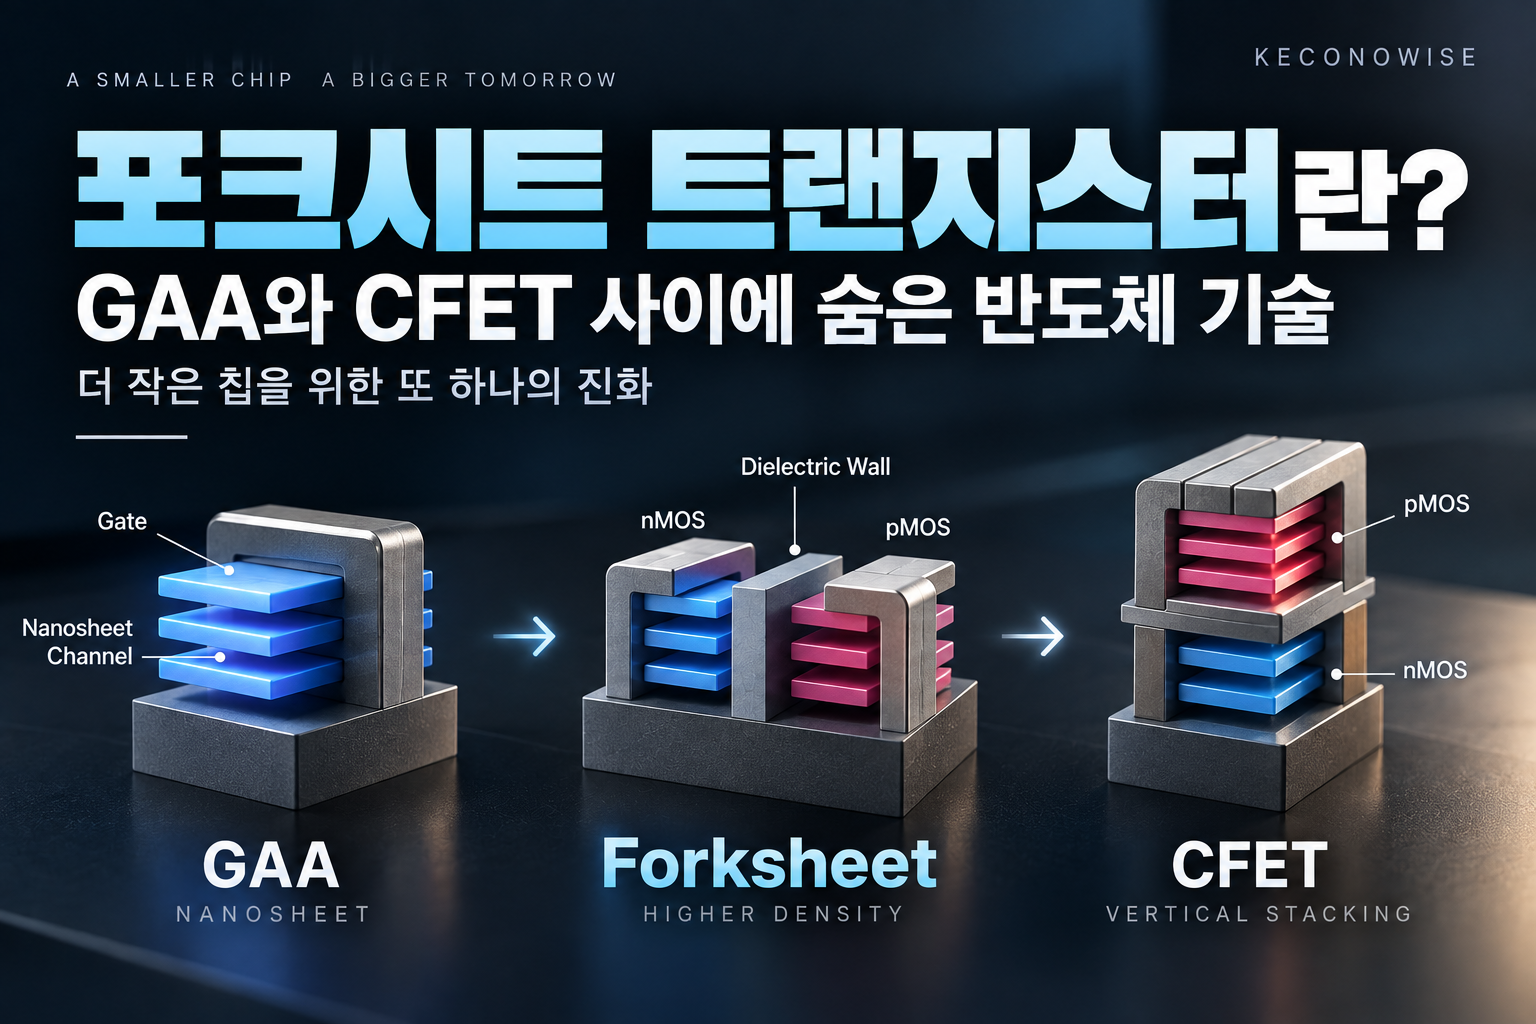
포크시트 트랜지스터란? GAA와 CFET 사이에 숨은 반도체 기술

GAA 나노시트와 CFET 사이의 포크시트 트랜지스터 구조 비교

반도체 트랜지스터의 발전 과정을 설명할 때 보통 이렇게 이야기한다. 평면 트랜지스터에서 FinFET으로. FinFET에서 GAA(Gate-All-Around) 나노시트로. 그리고 GAA 다음에는 nMOS와 pMOS를 위아래로 쌓는 CFET가 등장한다. 그런데 실제 차세대 반도체 기술 로드맵을 자세히 보면 GAA와 CFET 사이에 하나의 기술이 더 있다. 바로 포크시트 트랜지스터(Forksheet Transistor)다. 포크시트는 완전히 새로운 종류의 트랜지스터라기보다 GAA 나노시트 구조를 더 오래 미세화하기 위해 … 더 읽기