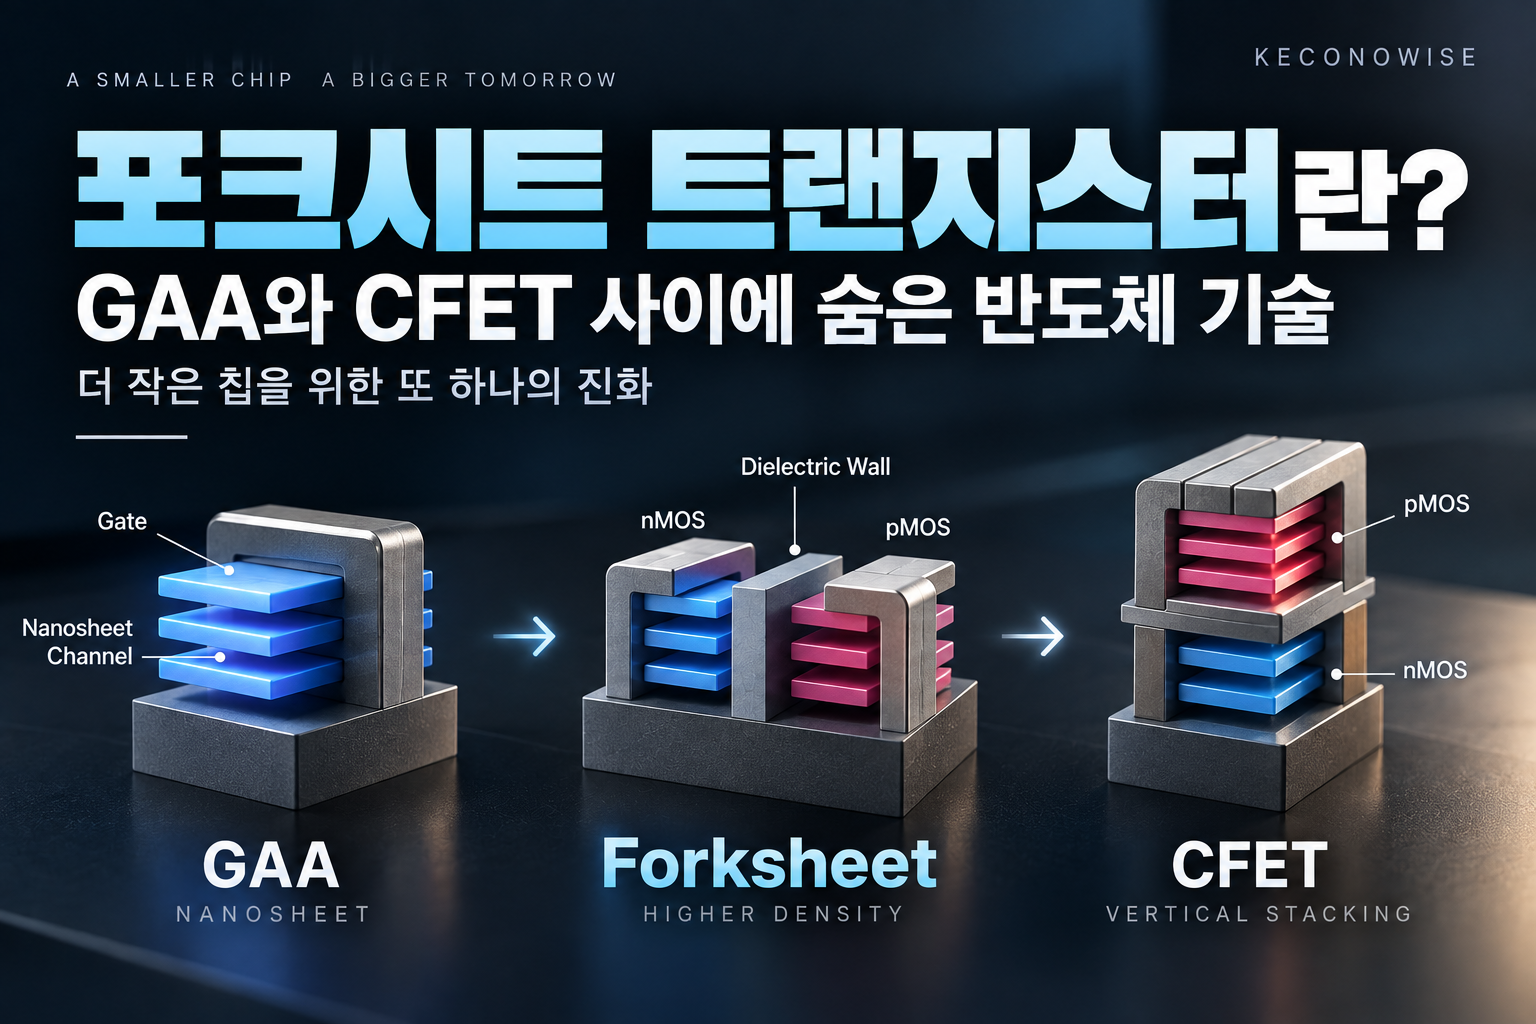
반도체 트랜지스터의 발전 과정을 설명할 때 보통 이렇게 이야기한다.
평면 트랜지스터에서 FinFET으로.
FinFET에서 GAA(Gate-All-Around) 나노시트로.
그리고 GAA 다음에는 nMOS와 pMOS를 위아래로 쌓는 CFET가 등장한다.
그런데 실제 차세대 반도체 기술 로드맵을 자세히 보면 GAA와 CFET 사이에 하나의 기술이 더 있다.
바로 포크시트 트랜지스터(Forksheet Transistor)다.
포크시트는 완전히 새로운 종류의 트랜지스터라기보다 GAA 나노시트 구조를 더 오래 미세화하기 위해 발전시킨 구조에 가깝다.
핵심 아이디어는 트랜지스터 사이에 절연벽을 넣어 서로 더 가까이 배치할 수 있도록 만드는 것이다.
2025년 imec은 기존 포크시트의 제조 문제를 개선한 Outer-wall Forksheet 구조를 공개했다.
그리고 imec의 로직 기술 로드맵에서는 이 구조를 GAA 나노시트 시대를 A10 세대까지 확장하고, 이후 A7부터 CFET로 넘어가기 위한 연결 기술 가운데 하나로 연구하고 있다.
그렇다면 왜 GAA에서 바로 CFET로 넘어가지 않고 중간에 포크시트가 필요한 것일까.
GAA 다음에 바로 CFET로 가면 안 될까
현재 첨단 로직 반도체의 중요한 변화 가운데 하나는 FinFET에서 GAA 나노시트로의 전환이다.
FinFET에서는 채널이 지느러미처럼 솟아 있고 게이트가 채널의 여러 면을 감싼다.
GAA 나노시트에서는 얇은 시트 형태의 채널을 여러 장 수직으로 쌓고 게이트가 채널을 사방에서 감싼다.
게이트가 채널을 더욱 강하게 제어할 수 있기 때문에 트랜지스터가 작아질수록 문제가 되는 단채널 효과를 억제하는 데 유리하다.
하지만 GAA 역시 무한정 작아질 수 있는 것은 아니다.
CMOS 논리회로에서는 nMOS와 pMOS가 함께 필요하다.
일반적인 GAA 나노시트 표준 셀에서는 n형과 p형 트랜지스터가 옆으로 배치되기 때문에 두 소자 사이에 일정한 공간이 필요하다.
표준 셀을 계속 줄이려면 이 간격도 줄여야 한다.
가장 근본적인 해결 방법 가운데 하나는 nMOS와 pMOS를 옆에 놓지 않고 위아래로 쌓는 것이다.
이것이 CFET(Complementary FET)다.
그러나 CFET는 GAA보다 훨씬 복잡한 구조다.
위쪽과 아래쪽에 서로 다른 트랜지스터가 있기 때문에 게이트와 소스·드레인 접점, 절연 구조와 전력 공급까지 좁은 공간에서 구현해야 한다.
imec은 이러한 통합 복잡성 때문에 자사의 연구 로드맵에서 CFET 도입을 A7 세대부터 예상하고 있다.
그렇다면 그 전에 GAA 나노시트를 조금 더 미세화할 방법이 필요하다.
그 역할을 위해 연구되는 기술이 포크시트 트랜지스터다.
포크시트 트랜지스터란 무엇인가
포크시트는 GAA 나노시트 계열의 구조를 유지하면서 트랜지스터 사이의 간격을 더 줄이기 위해 개발된 구조다.
imec이 2017년 처음 제안한 초기 Forksheet에서는 nMOS와 pMOS 사이에 유전체 절연벽(dielectric wall)을 배치했다.
이 벽이 두 트랜지스터를 물리적·전기적으로 분리하기 때문에 nMOS와 pMOS를 기존 GAA 나노시트보다 더 가까이 배치할 수 있다.
imec — Outer-wall Forksheet: bridging nanosheet and CFET
쉽게 비유하면 두 건물 사이에 아무것도 없다면 안전을 위해 일정한 거리를 확보해야 하지만, 가운데 적절한 벽을 만들 수 있다면 공간을 보다 효율적으로 사용할 수 있는 것과 비슷하다.
반도체에서는 이 몇 나노미터의 공간이 매우 중요하다.
수십억 개의 트랜지스터가 들어가는 칩에서는 개별 소자의 작은 면적 차이가 전체 칩의 집적도 차이로 이어질 수 있기 때문이다.
왜 이름이 Forksheet일까
Forksheet라는 이름은 초기 구조의 형태에서 나왔다.
GAA 나노시트에서는 게이트가 채널을 사방에서 감싼다.
초기의 inner-wall Forksheet에서는 절연벽 때문에 게이트가 채널의 네 면을 완전히 둘러싸지 못하고 세 면을 감싸는 tri-gate 형태가 된다.
이 구조가 단면에서 포크처럼 보이기 때문에 Forksheet라는 이름이 붙었다.
하지만 중요한 것은 이름보다 목적이다.
GAA 나노시트의 기본 구조와 공정을 최대한 활용하면서 표준 셀을 더 작게 만드는 것.
이것이 Forksheet의 핵심이다.
핵심은 트랜지스터 하나보다 ‘표준 셀’을 줄이는 것이다
포크시트를 이해하려면 반도체 미세화를 트랜지스터 하나의 크기만으로 보면 안 된다.
실제 CPU나 AI 가속기는 수많은 논리회로로 구성된다.
AND.
OR.
NAND.
NOR.
인버터.
이런 논리 기능을 구현하기 위해 여러 트랜지스터를 묶어 만든 기본 설계 단위를 표준 셀(Standard Cell)이라고 한다.
반도체 집적도를 높이려면 개별 트랜지스터뿐 아니라 이 표준 셀의 면적도 줄여야 한다.
표준 셀의 높이는 금속 배선의 track 수와 metal pitch의 영향을 받는다.
imec의 CMOS 로드맵에서는 FinFET에서 GAA nanosheet로 이동하면서 표준 셀 높이를 5-track 수준으로 줄이고, Forksheet를 추가적인 scaling 기술로 연구한다.
그다음 4-track 세대의 유력한 후보 가운데 하나가 CFET다.
즉 포크시트의 진짜 목적은 특이한 모양의 트랜지스터를 만드는 데 있지 않다.
같은 면적 안에 더 많은 논리 기능을 넣을 수 있도록 표준 셀을 압축하는 것이다.
기존 Inner-wall Forksheet에는 문제가 있었다
Forksheet 자체는 최근 갑자기 등장한 기술이 아니다.
imec은 2017년 처음 Forksheet 구조를 제안했고, 이후 300mm 웨이퍼 기반 공정까지 연구했다.
하지만 초기 Inner-wall Forksheet에는 제조상의 문제가 있었다.
이 구조에서는 nMOS와 pMOS 사이에 매우 얇은 절연벽을 만들어야 한다.
imec에 따르면 A10 세대에서 약 90nm의 logic standard-cell height를 구현하려면 이 절연벽의 폭이 약 8~10nm 수준까지 얇아져야 한다.
문제는 이 벽이 공정 초기에 만들어진다는 것이다.
이후 여러 FEOL 식각 공정을 계속 견뎌야 하기 때문에 벽이 추가로 얇아질 수 있다.
또 nMOS와 pMOS에 서로 다른 공정을 적용하기 위한 마스크를 이 좁은 벽 위에 정확히 정렬해야 한다.
게다가 실제 회로에서는 nMOS와 pMOS의 게이트를 서로 연결해야 하는 경우가 많은데, 가운데 위치한 절연벽이 이 연결을 어렵게 만들 수 있다.
또 다른 문제는 게이트 구조였다.
Inner-wall Forksheet에서는 게이트가 채널을 세 면에서 감싸는 tri-gate 형태가 되기 때문에 극도로 짧은 채널에서는 GAA보다 게이트 제어력이 떨어질 가능성이 있었다.
Forksheet의 면적 절감 아이디어는 매력적이었지만 제조 가능성을 높이기 위한 새로운 구조가 필요했던 것이다.
그래서 나온 것이 Outer-wall Forksheet다
imec은 기존 구조를 다시 설계했다.
그 결과가 Outer-wall Forksheet다.
imec은 2025년 VLSI Symposium에서 TCAD 시뮬레이션을 통해 이 구조의 특성을 공개했다.
가장 큰 변화는 절연벽의 위치다.
기존 Inner-wall Forksheet에서는 절연벽이 하나의 표준 셀 내부에서 nMOS와 pMOS 사이에 있었다.
Outer-wall 구조에서는 절연벽을 표준 셀의 경계로 이동시킨다.
따라서 벽의 양쪽에는 서로 다른 극성의 nMOS와 pMOS가 아니라 같은 종류의 트랜지스터가 놓일 수 있다.
nMOS와 nMOS.
또는 pMOS와 pMOS.
하나의 벽을 이웃한 표준 셀이 공유할 수 있는 구조다.
이 변화 덕분에 제조 조건도 완화된다.
imec에 따르면 기존 Inner-wall 구조에서 약 8~10nm 수준이던 절연벽을 Outer-wall 구조에서는 약 15nm까지 두껍게 만들 수 있다.
그러면서도 A10에서 약 90nm의 표준 셀 높이를 목표로 할 수 있다.
벽을 두껍게 만들 수 있다는 것은 제조 공정의 부담을 줄이는 데 도움이 된다.
Outer-wall Forksheet는 얼마나 작아질 수 있을까
imec은 SRAM과 ring oscillator를 이용해 Outer-wall Forksheet의 PPA(Power·Performance·Area)를 평가했다.
시뮬레이션에서 A10 Outer-wall Forksheet 기반 SRAM bit cell은 A14 nanosheet 기반 SRAM bit cell과 비교해 약 22%의 면적 감소가 나타났다.
이는 모든 실제 칩에서 SRAM 면적이 무조건 22% 줄어든다는 뜻은 아니다.
특정 기술 가정과 레이아웃을 기반으로 한 imec의 연구 결과다.
하지만 Forksheet가 왜 필요한지는 잘 보여준다.
GAA 나노시트의 기본적인 제조 흐름을 최대한 활용하면서도 표준 셀의 추가적인 면적 축소를 노릴 수 있기 때문이다.
이것이 imec이 Forksheet를 GAA nanosheet와 CFET 사이의 bridge로 표현하는 이유다.
‘Wall-last’ 방식은 왜 중요할까
Outer-wall Forksheet의 또 다른 특징은 wall-last integration이다.
기존 Inner-wall에서는 절연벽을 공정 초기에 만든다.
Outer-wall 구조에서는 반대로 주요 트랜지스터 공정을 진행한 뒤 비교적 뒤 단계에서 벽을 형성한다.
imec이 제시한 공정 흐름에서는 Si/SiGe stack을 만들고, nanosheet channel release와 source/drain 공정 등을 진행한 뒤 dielectric wall을 형성한다.
이 변화는 제조 편의성만을 위한 것이 아니다.
트랜지스터 성능과도 관련된다.
고성능 트랜지스터에서는 채널에 적절한 strain을 가해 전하 이동 특성을 높이는 방법이 사용된다.
Outer-wall 구조에서는 wall-last 접근을 통해 source/drain stressor를 이용한 full channel strain을 보다 효과적으로 구현할 가능성이 있다.
또 절연벽의 일부를 식각해 게이트가 채널의 네 번째 면까지 일부 감싸도록 만들 수 있다.
이른바 Ω(오메가)형 게이트다.
imec의 TCAD 시뮬레이션에서는 약 5nm의 wall etch-back 조건에서 drive current가 약 25% 증가하는 결과가 제시됐다.
다만 이 수치 역시 실제 상용 프로세서의 성능이 25% 향상된다는 의미가 아니다.
특정 Forksheet 구조에 대한 시뮬레이션 결과라는 점을 구분해야 한다.
포크시트는 A10, CFET는 A7?
imec의 현재 로직 기술 로드맵에서는 두 기술의 역할이 비교적 명확하게 구분된다.
먼저 GAA nanosheet 계열을 계속 발전시킨다.
그리고 Outer-wall Forksheet를 이용해 nanosheet 기반 로드맵을 A10까지 연장한다.
그다음 A7부터 nMOS와 pMOS를 수직으로 쌓는 CFET로 전환하는 방향을 연구하고 있다.
imec — Performance boosters to scale monolithic CFET
여기서 A10과 A7을 실제 물리적 길이로 해석하면 안 된다.
A10이 특정 구조의 길이가 정확히 1.0nm이고 A7이 0.7nm라는 의미가 아니다.
현대 첨단공정의 노드 명칭은 기술 세대를 구분하는 이름에 가깝다.
또 하나 중요한 점이 있다.
이것은 imec의 연구 로드맵이다.
TSMC, 삼성전자, Intel이 반드시 동일한 시점과 동일한 구조로 전환한다는 의미가 아니다.
각 반도체 제조사는 공정 성숙도와 비용, 성능, 고객 요구에 따라 다른 구조와 도입 시점을 선택할 수 있다.
따라서 현재 Forksheet를 가장 정확하게 설명하면 이렇다.
GAA nanosheet의 수명을 연장하고 CFET로 넘어가기 전 추가적인 집적도 향상을 노리는 차세대 트랜지스터 구조 가운데 하나다.
그런데 Forksheet는 CFET가 등장하면 사라질까
흥미로운 점은 그렇지 않을 가능성이 있다는 것이다.
imec은 2026년 2월 공개한 monolithic CFET 연구에서 A7 이후 CFET를 A5와 A3 세대로 계속 축소하는 방법을 분석했다.
A7에서는 gate parasitic capacitance를 줄이는 것이 중요하다.
그다음 A5에서는 Outer-wall Forksheet 구조를 CFET에 결합하는 방법이 필요할 수 있다고 분석했다.
imec — Performance boosters to scale monolithic CFET across multiple logic technology nodes
Outer-wall Forksheet의 wall-last 구조는 channel stress를 높이는 데 도움을 줄 수 있고, shared n-n 또는 p-p wall을 통해 gate extension을 줄여 parasitic capacitance를 낮추는 데도 유리할 수 있다.
A3 단계에서는 여기에 추가적인 성능 향상 기술이 필요하다.
imec은 nMOS와 pMOS에 서로 다른 최적의 결정 방향을 적용하는 hybrid channel orientation까지 연구하고 있다.
즉 Forksheet는 GAA와 CFET 사이에서 잠시 등장했다가 사라지는 기술이라고 단정하기 어렵다.
Forksheet에서 개발된 구조적 아이디어가 다시 CFET의 scaling booster로 활용될 가능성도 연구되고 있다.
반도체 기술 발전이 단순한 교체가 아닌 이유다.
포크시트가 등장하면 배선도 달라져야 한다
트랜지스터만 줄인다고 끝나는 것도 아니다.
표준 셀의 크기가 작아지면 그 안에 신호와 전력을 연결할 공간도 줄어든다.
트랜지스터 사이의 간격을 줄이면 그 위에 있는 접점과 금속 배선 역시 더 촘촘하게 만들어야 한다.
그런데 금속 배선은 이미 새로운 미세화 문제를 겪고 있다.
Keconowise에서는 앞서 구리 배선이 극도로 좁아질 때 저항과 RC 지연 문제가 커지고, 루테늄이 차세대 초미세 배선 소재 후보로 연구되는 이유를 살펴봤다.
구리는 왜 2나노 아래에서 느려지나 — 인텔이 루테늄 배선을 꺼낸 이유
결국 트랜지스터 구조가 바뀌면 배선도 함께 바뀌어야 한다.
포크시트와 CFET 같은 차세대 구조가 중요한 이유는 트랜지스터 하나만의 변화가 아니라 접점과 전력망, 배선까지 함께 다시 설계하게 만들기 때문이다.
후면전력공급과도 연결된다
표준 셀을 줄일 때 또 하나 큰 문제가 되는 것이 전력 배선이다.
전력선과 신호선이 모두 웨이퍼 앞면의 제한된 배선 공간을 사용하면 초미세 표준 셀을 만드는 데 부담이 커질 수 있다.
그래서 전력망을 웨이퍼 뒤쪽으로 이동시키는 후면전력공급이 중요해지고 있다.
Keconowise에서도 이 기술을 앞서 살펴봤다.
후면전력공급이란? AI 반도체 2나노 경쟁의 핵심 기술
전력 배선을 뒤쪽으로 분리하면 앞면의 배선 자원을 신호 연결에 보다 집중적으로 사용할 수 있다.
그리고 CFET처럼 트랜지스터가 수직으로 쌓이면 아래쪽 트랜지스터에 어떻게 전력과 신호를 연결할 것인지가 더욱 어려운 문제가 된다.
실제로 imec은 CFET 연구에서 bottom pMOS의 source/drain에 직접 연결하는 backside contact까지 실험적으로 연구하고 있다.
즉 Forksheet → CFET → backside connectivity는 서로 완전히 분리된 기술이 아니다.
표준 셀을 계속 줄이기 위해 함께 발전해야 하는 기술들이다.
AI 반도체에서 포크시트가 중요한 이유
AI 반도체와 Forksheet는 HBM처럼 직접 연결돼 보이지 않는다.
HBM은 GPU가 데이터를 기다리는 시간을 줄인다.
첨단 패키징은 여러 대형 다이와 HBM을 하나의 시스템으로 연결한다.
Forksheet는 그보다 훨씬 아래쪽인 트랜지스터와 표준 셀 수준의 기술이다.
하지만 AI 가속기는 막대한 수의 트랜지스터를 필요로 한다.
같은 면적에서 더 많은 연산 기능을 구현하거나 같은 연산량을 더 작은 면적과 전력으로 처리하려면 로직 집적도를 계속 높여야 한다.
물론 Forksheet 하나가 AI 가속기의 성능을 결정하는 것은 아니다.
AI 반도체의 실제 성능은 트랜지스터뿐 아니라 HBM, 인터커넥트, 패키징, 전력 공급, 냉각과 소프트웨어까지 여러 요소의 영향을 받는다.
하지만 그 모든 시스템의 가장 아래에는 결국 논리회로가 있다.
같은 면적 안에 얼마나 많은 효율적인 논리회로를 넣을 수 있는가.
Forksheet는 바로 이 문제를 해결하려는 기술 가운데 하나다.
2D 반도체까지 연결하면 로드맵이 보인다
Forksheet 이후에는 CFET가 있다.
그리고 그보다 더 장기적인 연구에서는 실리콘 채널 자체를 원자층 수준의 2D 반도체 소재로 바꾸는 방향도 검토되고 있다.
imec의 CMOS scaling 연구에서도 nanosheet 이후 Forksheet와 CFET가 이어지고, 그보다 더 먼 미래의 초미세 로직을 위해 2D 소재와 atomic channel을 연구하고 있다.
최근 Keconowise에서 살펴본 기술들을 연결하면 하나의 큰 흐름이 만들어진다.
GAA → Forksheet → CFET → 2D channel
GAA는 게이트가 채널을 사방에서 감싼다.
Forksheet는 트랜지스터 사이의 공간을 더 줄인다.
CFET는 nMOS와 pMOS를 위아래로 쌓는다.
2D 반도체는 실리콘보다 훨씬 얇은 원자층 수준의 채널을 사용하려 한다.
이것이 반드시 모든 반도체 제조사가 그대로 따르게 될 확정된 양산 순서라는 의미는 아니다.
하지만 연구 방향은 분명하다.
평면에서 줄일 수 있는 공간이 부족해질수록 구조와 소재, 배선과 전력 공급까지 동시에 바뀌고 있다.
Keconowise View: 반도체 로드맵은 ‘교체’보다 ‘연결’에 가깝다
반도체 기술을 단순하게 보면 한 세대가 끝나고 다음 세대가 시작되는 것처럼 보인다.
FinFET이 끝나면 GAA.
GAA가 끝나면 CFET.
CFET 다음에는 새로운 채널 소재.
하지만 실제 기술 로드맵은 그렇게 단순하지 않다.
Forksheet가 좋은 사례다.
Forksheet는 GAA를 완전히 버리기 위해 만든 기술이 아니다.
오히려 기존 GAA nanosheet의 제조 기반을 최대한 활용하면서 그 수명을 연장하기 위해 개발됐다.
그리고 2026년 연구에서는 Forksheet에서 발전한 Outer-wall 구조를 다시 CFET에 결합해 A5 이후 CFET의 성능을 유지하는 방법까지 검토되고 있다.
즉 기존 기술을 버리고 새 기술로 교체하는 것이 아니라 기존 기술의 아이디어를 다음 구조에 다시 조합하는 방식으로 반도체는 발전한다.
이 관점에서 최근 Keconowise에서 살펴본 기술들도 하나로 연결된다.
루테늄은 더 좁아지는 배선을 보완한다.
후면전력공급은 전력망을 앞면에서 분리한다.
CFET는 nMOS와 pMOS를 위아래로 쌓는다.
2D 반도체는 채널 소재 자체를 다시 설계한다.
그리고 Forksheet는 그 변화 사이에서 GAA nanosheet가 한 단계 더 미세해질 수 있도록 공간을 확보하는 기술이다.
반도체 미세화의 핵심 질문은 더 이상 단순히 ‘몇 나노인가’가 아니다.
같은 공간을 어떻게 더 효율적으로 사용할 것인가.
트랜지스터를 얼마나 가까이 배치할 것인가.
전력망을 어디에 둘 것인가.
배선에는 어떤 금속을 사용할 것인가.
언제 트랜지스터를 수직으로 쌓을 것인가.
그리고 기존 구조를 얼마나 오래 확장할 수 있는가.
Forksheet는 이 변화를 잘 보여준다.
GAA와 CFET 사이에는 단순한 공백이 있는 것이 아니다.
그 사이에서도 반도체 산업은 기존 나노시트 구조에서 한 세대의 집적도를 더 끌어내기 위해 트랜지스터를 다시 설계하고 있다.
포크시트 트랜지스터를 주목해야 하는 이유다.
참고 자료
- imec — Outer-wall Forksheet: bridging nanosheet and CFET device architectures
- imec — CMOS Scaling
- imec — Performance boosters to scale monolithic CFET across multiple logic technology nodes
이 글은 공개된 연구기관 자료를 바탕으로 차세대 반도체 기술의 발전 방향을 분석한 콘텐츠입니다. A10·A7·A5·A3 등의 표기는 imec의 연구 로드맵에 따른 기술 세대이며 특정 파운드리의 확정된 상용화 일정이나 실제 물리적 치수를 의미하지 않습니다.