AI 반도체 경쟁을 이야기할 때 가장 먼저 등장하는 숫자는 보통 ‘몇 나노’다.
3나노에서 2나노로 미세공정이 발전하면서 하나의 칩에 더 많은 트랜지스터를 집적하는 경쟁이 이어지고 있다.
그런데 AI 가속기 전체를 보면 정반대의 변화도 동시에 나타난다.
트랜지스터는 작아지는데, AI 반도체 패키지는 오히려 커지고 있다.
하나의 거대한 GPU나 AI ASIC만으로 필요한 연산 성능을 모두 확보하기 어려워지면서 여러 개의 컴퓨트 다이와 HBM을 하나의 패키지 안에 넣는 구조가 확대되고 있기 때문이다.
여기서 새로운 물리적 한계가 등장한다.
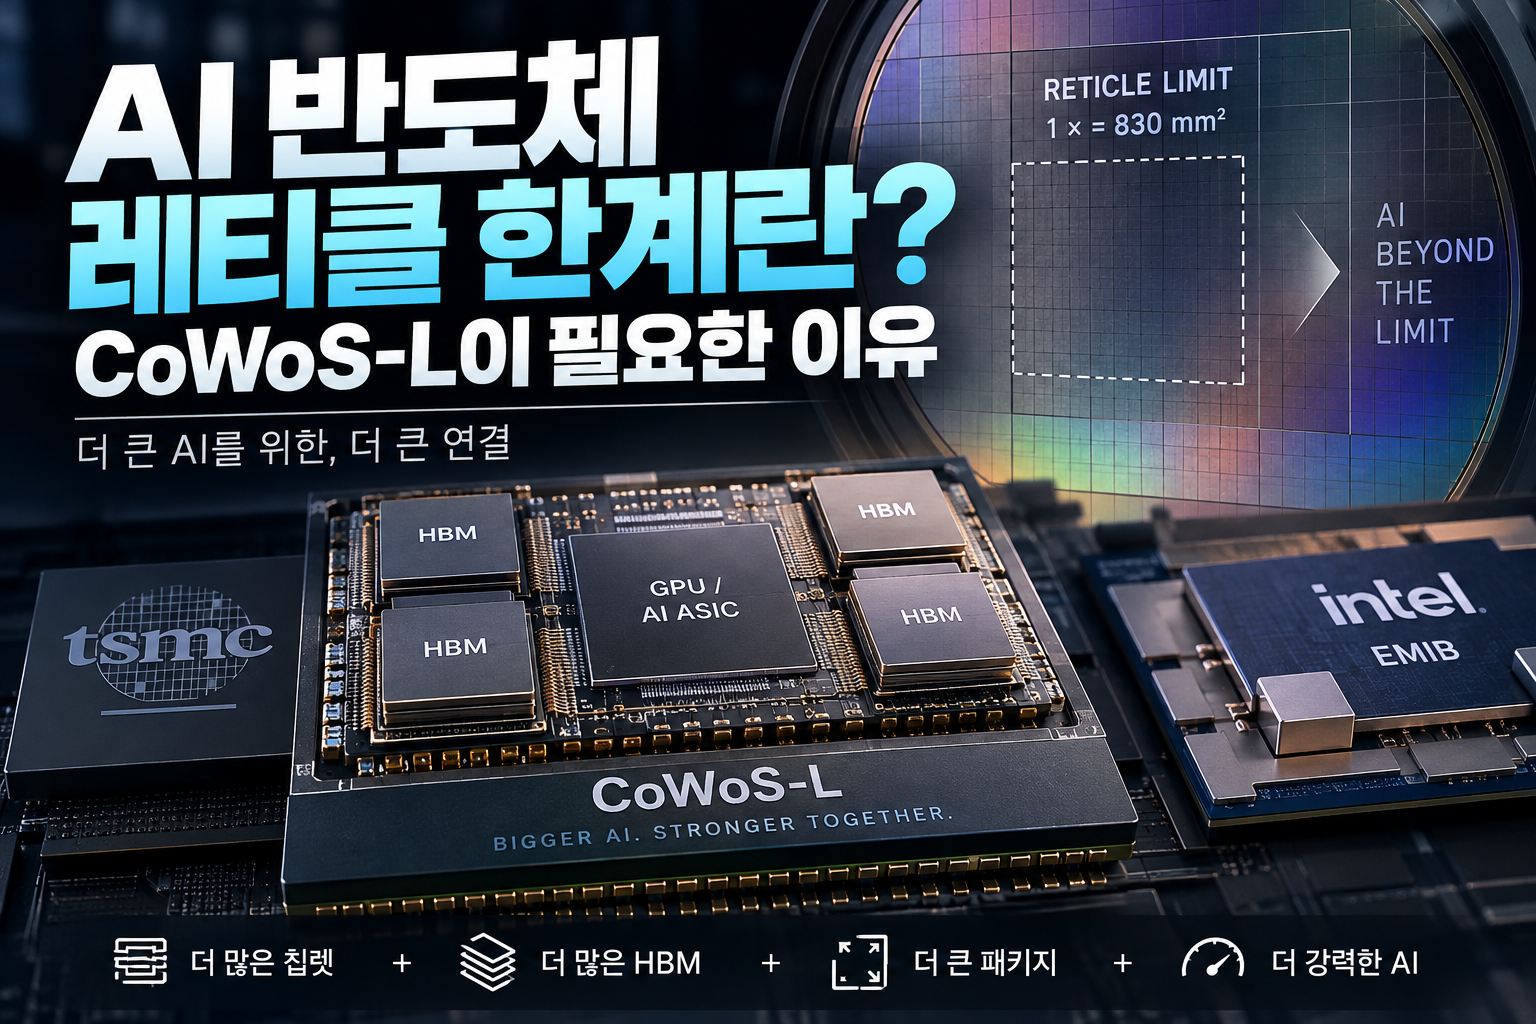
바로 AI 반도체 레티클 한계(Reticle Limit)다.
최근 TSMC의 CoWoS-L과 Intel의 EMIB 같은 첨단 패키징 기술이 중요해지는 이유를 이해하려면 먼저 이 레티클 한계를 살펴볼 필요가 있다.
레티클 한계란 무엇인가
반도체는 포토리소그래피 공정을 통해 웨이퍼 위에 회로 패턴을 만든다.
이때 노광 장비가 한 번에 패턴을 형성할 수 있는 영역에는 크기 제한이 있다. 이를 일반적으로 레티클 한계라고 부른다.
과거에는 이 문제가 주로 하나의 반도체 다이를 얼마나 크게 만들 수 있느냐와 연결됐다.
하지만 AI 시대에는 문제가 패키징 영역으로 확장되고 있다.
GPU와 AI ASIC, 여러 칩렛과 HBM을 하나의 시스템처럼 연결하려면 이들을 연결하는 인터포저 역시 커져야 하기 때문이다.
TSMC에 따르면 CoWoS-S의 실리콘 인터포저는 지난 10년 동안 1-reticle에서 3.3-reticle 크기까지 확대됐다. TSMC는 하나의 레티클 면적을 약 830㎟로 설명한다.
하지만 AI 가속기에 들어가는 컴퓨트 다이와 HBM의 수가 증가하면서 더 큰 연결 공간이 필요해지고 있다.
TSMC 2024 Annual Report — CoWoS 기술 로드맵
결국 질문이 달라진다.
칩을 얼마나 작게 만들 수 있는가가 아니라, 여러 개의 칩을 얼마나 큰 하나의 시스템으로 연결할 수 있는가.
AI 반도체 패키징 경쟁에서 레티클 한계가 중요해진 이유다.
CoWoS-S는 왜 계속 커지기 어려울까
CoWoS는 Chip-on-Wafer-on-Substrate의 약자다.
쉽게 말하면 GPU나 AI ASIC 같은 로직 칩과 HBM을 인터포저 위에 배치하고 이를 다시 패키지기판에 올리는 2.5D 패키징 기술이다.
그중 CoWoS-S는 실리콘 인터포저를 이용한다.
실리콘은 높은 배선 밀도를 구현할 수 있어 컴퓨트 다이와 HBM 사이에서 대량의 데이터를 이동시키는 데 유리하다.
하지만 AI 칩이 커질수록 문제가 생긴다.
컴퓨트 다이가 늘어나고 HBM 스택 수도 증가하면 이들을 연결하는 인터포저 역시 더 넓어져야 한다.
대형 실리콘 인터포저는 제조 복잡도와 비용 부담을 높일 수 있고, 계속 크기를 확장하는 데에도 물리적인 제약이 따른다.
TrendForce는 2026년 9월 18일 발표한 분석에서 AI 칩의 크기와 HBM 탑재량이 증가하면서 실리콘 인터포저 제조가 물리적 한계에 접근하고 있다고 분석했다.
TrendForce에 따르면 CoWoS-S는 2개의 SoC·칩렛과 8개의 HBM 모듈을 통합하는 구성에 활용될 수 있다. 반면 그보다 더 많은 SoC·칩렛과 HBM을 요구하는 설계에서는 CoWoS-L로의 전환 필요성이 커진다.
TrendForce — AI Chip Packaging Pushes Beyond Reticle Limits, 2026년 9월 18일
그래서 CoWoS-L은 무엇을 바꾸는가
CoWoS-L의 핵심은 패키지 전체를 하나의 대형 실리콘 인터포저에 의존하는 방식과 다르다는 점이다.
TSMC는 CoWoS-L에 RDL(Redistribution Layer) 기반 인터포저와 LSI(Local Silicon Interconnect)를 결합한다.
전체 영역을 대형 실리콘 인터포저로 구성하는 대신 높은 배선 밀도가 필요한 영역에 LSI를 활용하는 구조다.
TSMC는 CoWoS-L이 RDL 기반 인터포저와 고밀도 LSI, eDTC(embedded Deep Trench Capacitor)를 결합해 더 큰 HPC 제품을 구현할 수 있도록 설계됐다고 설명한다.
그리고 이 기술은 아직 연구실에만 있는 기술이 아니다.
TSMC는 3.5-reticle 크기의 첫 CoWoS-L을 2024년부터 양산하고 있다.
TSMC의 2024년 연차보고서에는 그다음 단계인 5.5-reticle 크기 CoWoS-L 개발도 시작했다고 명시돼 있다.
AI 패키지가 레티클 한계를 넘어 더 커지는 흐름이 실제 양산 기술 로드맵에 들어온 것이다.
왜 AI 가속기는 계속 커지고 있을까
AI 가속기의 성능을 높이는 가장 단순한 방법은 연산 다이를 계속 크게 만드는 것이다.
하지만 하나의 다이를 무한정 키울 수는 없다.
레티클 한계가 존재하고 다이 면적이 커질수록 웨이퍼에서 얻을 수 있는 칩 수와 결함 관리가 어려워지기 때문이다.
그래서 반도체 산업은 여러 다이와 칩렛을 고속으로 연결하는 방향으로 이동하고 있다.
여기에 HBM까지 추가된다.
AI 모델이 커질수록 연산 성능뿐 아니라 데이터를 GPU에 공급하는 메모리 대역폭과 용량 역시 중요해지기 때문이다.
결국 패키지 안에는 컴퓨트 다이와 여러 개의 HBM, 그리고 이를 연결하는 복잡한 배선 구조가 들어가게 된다.
최근 Keconowise에서 살펴본 칩렛과 UCIe 역시 같은 변화에서 등장했다.
AI 반도체는 왜 하나의 거대한 칩을 버리나 — 칩렛과 UCIe가 만드는 다음 반도체 전쟁
칩을 하나의 거대한 다이로 만드는 대신 여러 칩렛으로 나눈다면 그다음 문제는 명확하다.
나눠진 칩을 어떻게 하나의 칩처럼 빠르게 연결할 것인가.
CoWoS-L과 같은 첨단 패키징이 중요해지는 이유다.
NVIDIA와 AMD도 CoWoS-L을 사용하고 있다
이 변화는 실제 AI 가속기에서도 나타나고 있다.
TrendForce는 2026년 9월 18일 보고서에서 NVIDIA와 AMD의 AI 가속기가 이미 CoWoS-L을 채택하고 있다고 설명했다.
AI ASIC에서도 같은 움직임이 나타난다.
TrendForce에 따르면 Meta의 MTIA 400은 CoWoS-L을 사용하고 있으며 AWS와 Microsoft도 2027년 CoWoS-L 채택이 예상된다.
다만 여기서는 구분이 필요하다.
NVIDIA·AMD·Meta 사례는 TrendForce가 현재 채택 사례로 설명한 것이고, AWS와 Microsoft는 향후 적용 전망이다.
따라서 모두 이미 CoWoS-L을 사용하고 있다고 보는 것은 정확하지 않다.
중요한 것은 특정 기업 이름보다 방향이다.
AI 연산량이 증가할수록 더 많은 컴퓨트 다이와 더 많은 HBM이 필요해지고, 그만큼 이들을 연결하는 패키징 기술의 중요성도 커지고 있다.
AI 반도체의 성능 경쟁이 GPU 설계에서 HBM으로, 다시 첨단 패키징으로 확장되고 있는 것이다.
Intel EMIB는 무엇이 다를까
TSMC만 대형 AI 패키지 문제를 해결하려는 것은 아니다.
Intel은 EMIB(Embedded Multi-die Interconnect Bridge)라는 다른 접근법을 발전시키고 있다.
EMIB는 패키지 전체를 거대한 실리콘 인터포저로 만드는 대신 칩과 칩을 연결해야 하는 영역에 작은 실리콘 브리지를 삽입한다.
Intel은 EMIB를 로직과 로직, 로직과 HBM을 연결할 수 있는 2.5D 패키징 기술로 설명한다.
Intel Foundry — Advanced Packaging
최근에는 여기에 EMIB-T도 등장했다.
EMIB-T는 기존 EMIB 브리지에 TSV(Through-Silicon Via)를 추가한 구조다.
Intel에 따르면 TSV를 이용하면 기판 아래에서 칩 방향으로 전력을 보다 직접적으로 전달할 수 있으며, 고대역폭 메모리가 요구하는 전력 공급과 신호 라우팅을 개선하는 데 활용할 수 있다.
Intel Foundry — Advanced Packaging for Next-Generation AI Semiconductors
TrendForce는 대형 인터포저의 비용 부담과 TSMC 패키징 생산능력 제약 때문에 Intel EMIB 계열 기술에도 관심이 커지고 있다고 분석했다.
즉 CoWoS-L과 EMIB는 구조는 다르지만 같은 질문을 해결하려 한다.
하나의 칩을 계속 크게 만드는 대신 여러 개의 칩을 어떻게 하나의 거대한 시스템처럼 연결할 것인가.
유리기판과 CoWoS-L은 어떻게 연결될까
최근 Keconowise에서는 AI 반도체에서 유리기판이 주목받는 이유를 살펴봤다.
AI 반도체는 왜 유리 위에 올라가려 하나 — 유리기판이 차세대 패키징의 핵심으로 떠오른 이유
유리기판과 CoWoS-L은 같은 기술이 아니다.
CoWoS-L은 컴퓨트 다이와 HBM 등을 고밀도로 연결하는 첨단 패키징 구조이고, 유리기판은 대형 패키지를 지지하고 연결하는 차세대 패키지기판 소재와 관련된 기술이다.
하지만 두 기술이 주목받는 배경은 연결돼 있다.
AI 반도체 패키지가 계속 커지고 있기 때문이다.
패키지가 커지면 칩 사이 연결뿐 아니라 패키지 전체의 휨과 열팽창, 배선 밀도와 전력 공급 같은 문제까지 함께 해결해야 한다.
따라서 AI 반도체 대형화는 인터포저만의 문제가 아니다.
인터포저와 패키지기판, 본딩, 전력 공급, 냉각 기술이 하나의 시스템처럼 함께 발전해야 한다.
HBM 하이브리드 본딩도 같은 문제를 보여준다
HBM에서는 비슷한 변화가 수직 방향으로 나타난다.
AI 가속기에 더 많은 메모리를 넣기 위해 HBM 적층 수가 증가하면 D램 사이의 연결 구조 역시 더 미세해져야 한다.
기존 범프 기반 접합을 계속 미세화하는 데 한계가 나타날 가능성이 있기 때문에 Cu-Cu 하이브리드 본딩이 차세대 연결 기술로 주목받고 있다.
HBM은 얼마나 더 높이 쌓을 수 있을까? 하이브리드 본딩이 필요해진 이유
두 기술을 함께 보면 AI 반도체가 어디로 이동하고 있는지가 선명해진다.
HBM에서는 위로 더 촘촘하게 연결해야 한다.
CoWoS-L에서는 옆으로 더 많은 칩을 연결해야 한다.
유리기판에서는 더 커진 패키지를 안정적으로 지지해야 한다.
그리고 칩 내부에서는 또 다른 변화가 진행되고 있다.
최근 Keconowise에서 살펴본 후면전력공급은 신호 배선과 전력 공급의 병목을 줄이기 위해 전력을 칩의 뒷면에서 공급하려는 기술이다.
후면전력공급이란? AI 반도체 2나노 경쟁의 핵심 기술
배선 소재에서도 변화가 시작됐다.
구리 배선이 극미세 영역에서 새로운 제약에 직면하면서 루테늄 같은 차세대 금속이 주목받고 있다.
구리는 왜 2나노 아래에서 느려지나 — 루테늄 반도체 배선이 뜨는 이유
이 기술들은 서로 다른 문제를 해결하지만 하나의 방향으로 연결된다.
AI 반도체 경쟁이 더 이상 트랜지스터 하나의 성능만으로 결정되지 않는다는 것이다.
이제 패키징은 ‘포장’이 아니다
과거 반도체 패키징은 완성된 칩을 외부 환경으로부터 보호하고 메인보드와 연결하는 후공정이라는 이미지가 강했다.
하지만 칩렛 시대에는 역할이 달라진다.
하나의 패키지 안에 여러 개의 컴퓨트 다이와 HBM을 넣고 이들을 초고속으로 연결해야 한다.
어떤 칩을 어디에 배치하고 어떤 연결 구조를 사용할지가 전체 시스템의 성능과 전력 효율에 직접 영향을 미칠 수 있다.
Intel 역시 AI 시대의 첨단 패키징을 여러 전문화된 칩을 하나의 강력한 시스템으로 연결하는 핵심 기술로 설명하고 있다.
TSMC 역시 CoWoS를 HPC와 AI 시스템 확장을 위한 핵심 기술로 발전시키고 있다.
즉 패키징은 더 이상 칩을 만든 뒤 마지막에 처리하는 단순한 ‘포장’이 아니다.
AI 반도체의 구조 자체를 결정하는 설계 영역으로 이동하고 있다.
Keconowise View: AI 반도체 경쟁의 단위가 칩에서 시스템으로 커지고 있다
최근 AI 반도체 기술을 하나씩 보면 서로 다른 기술처럼 보인다.
HBM.
하이브리드 본딩.
칩렛과 UCIe.
유리기판.
후면전력공급.
차세대 금속 배선.
그리고 CoWoS-L.
하지만 조금 떨어져서 보면 이 기술들은 같은 변화를 보여준다.
하나의 반도체 칩을 계속 작게 만드는 것만으로는 AI가 요구하는 성능 증가를 해결하기 어려워지고 있다는 것이다.
그래서 산업은 여러 방향에서 동시에 병목을 없애고 있다.
트랜지스터는 더 작게 만든다.
메모리는 HBM으로 위로 쌓는다.
연산 칩은 여러 칩렛으로 나눈다.
칩렛과 HBM은 더 넓은 패키지 안에서 연결한다.
커진 패키지는 더 안정적인 기판 위에 올린다.
칩 내부에서는 신호와 전력이 지나가는 길까지 다시 설계한다.
결국 AI 반도체 경쟁의 단위가 ‘트랜지스터’에서 ‘칩’으로, 다시 ‘패키지와 시스템’으로 확대되고 있는 것이다.
이 관점에서 레티클 한계는 단순히 노광 장비가 가진 크기 제한 이상의 의미를 갖는다.
하나의 거대한 칩을 계속 키우는 방식에 물리적인 경계가 존재한다는 뜻이기 때문이다.
그리고 그 경계를 넘기 위해 반도체 산업은 칩 자체를 무한정 키우는 대신 여러 개의 칩을 하나의 시스템처럼 연결하는 방향으로 움직이고 있다.
CoWoS-L과 EMIB가 중요한 이유도 바로 여기에 있다.
앞으로 AI 반도체를 볼 때는 ‘몇 나노인가’만 볼 것이 아니다.
하나의 패키지 안에 얼마나 많은 컴퓨트 다이와 메모리를 넣고, 이들을 얼마나 빠르고 안정적으로 연결할 수 있는가.
그 질문이 점점 더 중요해지고 있다.
AI 반도체의 다음 경쟁은 더 작은 칩을 만드는 것만이 아니다.
더 큰 시스템을 하나의 칩처럼 작동시키는 경쟁이 시작되고 있다.