AI 반도체 경쟁에서 엔비디아가 장악한 영역은 GPU만이 아니다.
GPU와 GPU를 연결하는 NVLink, 서버를 묶는 네트워크, 랙 구조, 소프트웨어까지 영향력을 넓혀왔다.
그런데 이제 엔비디아가 한 단계 더 안쪽으로 들어가고 있다.
이번에는 HBM이다.
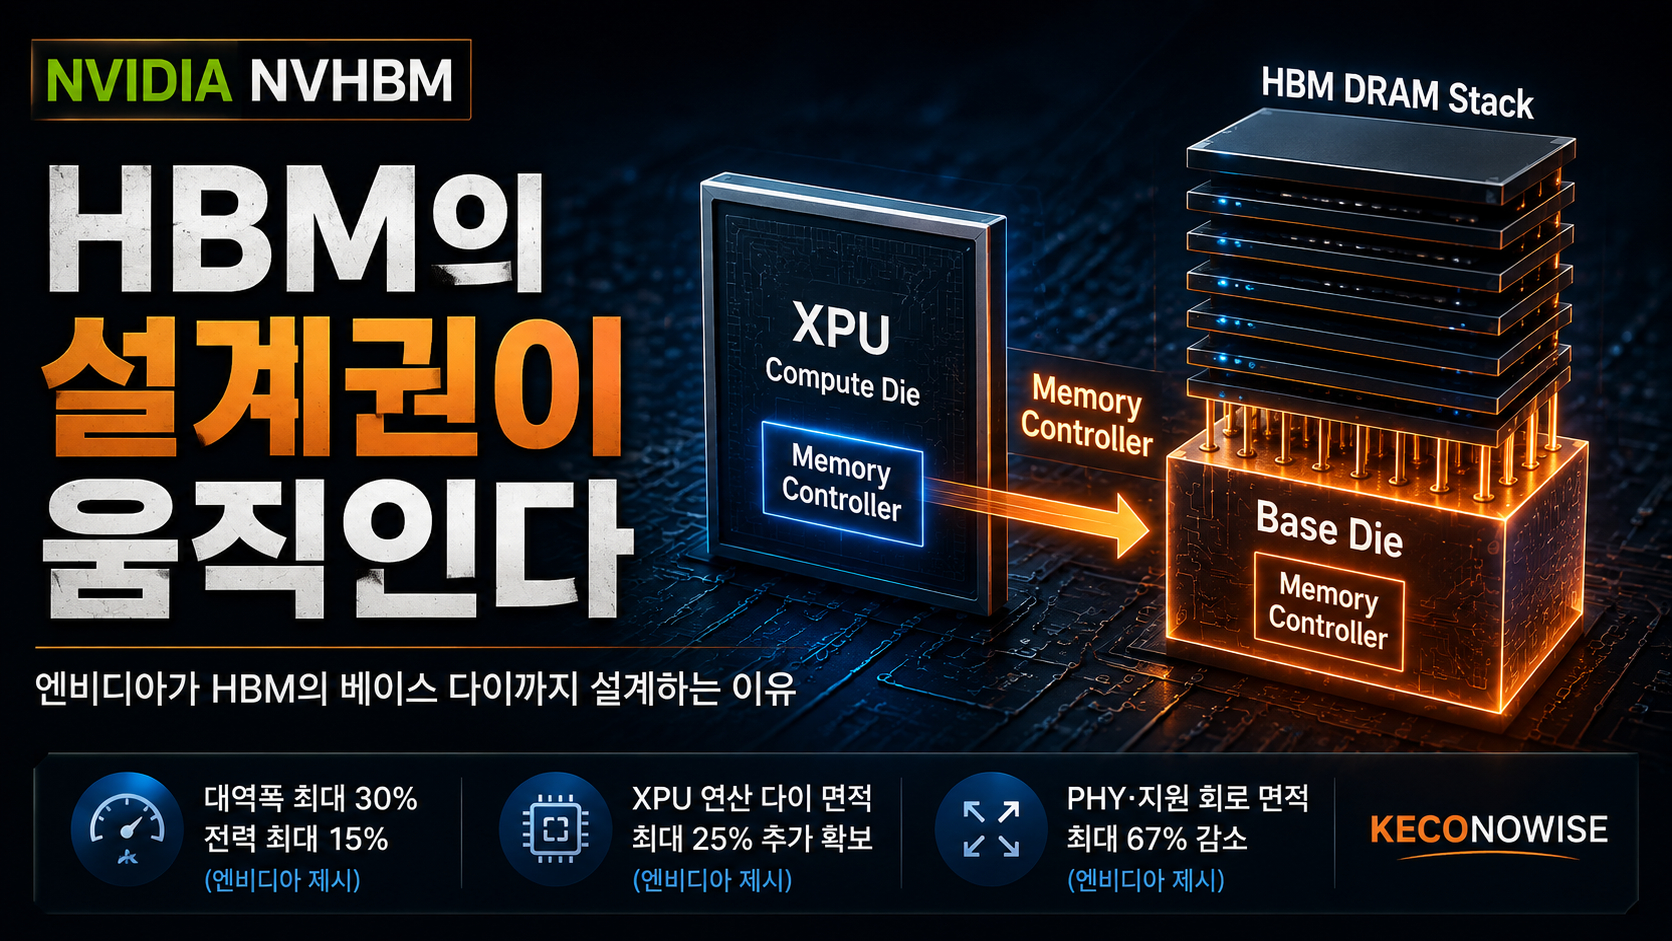
엔비디아는 2026년 8월 26일 NVLink Fusion을 확장하면서 새로운 커스텀 고대역폭메모리 기술인 NVHBM을 공개했다.
핵심은 엔비디아가 DRAM을 직접 만든다는 것이 아니다.
기존 XPU 연산 다이에 있던 메모리 컨트롤러를 HBM 가장 아래에 있는 베이스 다이(Base Die)로 옮기고, 그 안에 엔비디아의 커스텀 메모리 컨트롤러를 넣는다는 것이다.
겉으로 보면 메모리 인터페이스 구조를 바꾸는 기술처럼 보인다.
하지만 이 변화가 중요한 이유는 따로 있다.
HBM에서 누가 더 많은 부가가치를 가져갈지를 결정하는 ‘설계 주도권’이 움직이기 시작했기 때문이다.
엔비디아 커스텀 HBM, 무엇이 달라졌나
HBM은 여러 개의 DRAM 다이를 수직으로 쌓고 그 아래 베이스 다이를 배치하는 구조다.
AI 가속기의 연산 성능이 빠르게 높아지면서 HBM 역시 더 많은 데이터를 더 빠르게 공급해야 했다.
하지만 대역폭을 계속 높이는 과정에서 새로운 문제가 생긴다.
기존 HBM 구조에서는 메모리 컨트롤러가 XPU 연산 다이에 위치한다. HBM과 데이터를 주고받기 위한 PHY와 지원 회로 역시 귀중한 실리콘 면적을 사용한다.
NVHBM은 이 구조를 바꾼다.
메모리 컨트롤러를 HBM 베이스 다이 안으로 옮기고 커스텀 PHY를 적용해 XPU와 HBM 사이의 인터페이스가 차지하는 공간을 줄이는 방식이다.
엔비디아가 공개한 수치는 다음과 같다.
| 항목 | 엔비디아가 제시한 NVHBM 효과 |
|---|---|
| 메모리 대역폭 | 표준 HBM4E 대비 최대 30% 증가 |
| HBM 전력 소비 | 최대 15% 감소 |
| XPU 연산 다이 면적 | 최대 25% 추가 확보 |
| PHY·지원 회로 면적 | 최대 67% 감소 |
| 첫 NVHBM 협력사 | Amazon Annapurna Labs |
다만 이 숫자들은 현재 엔비디아가 자체 설계 비교를 통해 제시한 수치다.
NVHBM을 탑재한 상용 XPU를 대상으로 한 독립적인 벤치마크 결과가 나온 것은 아니다.
따라서 최대 30%의 대역폭 향상이나 최대 15%의 전력 절감을 이미 상용 환경에서 검증된 성능으로 해석해서는 안 된다.
또 엔비디아 기술 블로그의 비교표와 기업 블로그는 XPU 연산 다이 면적을 ‘최대 25% 추가 확보’로 제시한다. 반면 같은 기술 블로그 본문에는 인터페이스 축소로 ‘사용 가능한 main-die silicon’을 최대 30% 늘릴 수 있다는 표현도 있다. 같은 문서 안에서도 기준에 따라 표기가 다른 셈이다. 이 글에서는 비교표에 제시된 25%를 기준으로 한다.
왜 메모리 컨트롤러를 HBM 밑으로 옮기려는 걸까
AI 가속기의 문제를 단순하게 표현하면 이렇다.
연산 능력이 아무리 높아도 데이터를 제때 공급하지 못하면 연산장치는 기다려야 한다.
이른바 메모리 병목이다.
그래서 GPU 바로 옆에 넓은 데이터 통로를 가진 HBM을 배치했다.
하지만 HBM의 대역폭을 계속 높이면 이번에는 HBM과 연산 칩을 연결하는 인터페이스가 커진다.
엔비디아에 따르면 표준 HBM4E와 비교할 때 NVHBM의 커스텀 구조는 PHY와 지원 회로가 차지하는 면적을 최대 67% 줄일 수 있다.
줄어든 인터페이스 공간은 다시 연산 기능에 사용할 수 있다.
결국 NVHBM의 핵심은 HBM 하나를 조금 더 빠르게 만드는 데 있지 않다.
XPU와 HBM을 서로 독립적인 두 부품이 아니라 하나의 시스템처럼 공동 설계하는 것이다.
HBM4 이후 베이스 다이가 중요한 이유도 여기에 있다.
과거 베이스 다이가 데이터를 연결하고 제어하는 역할에 가까웠다면, 첨단 로직 공정이 적용되면서 더 많은 기능을 넣을 수 있는 공간으로 변하고 있다.
첫 파트너가 AWS 안나푸르나랩스인 이유
NVHBM의 첫 협력사는 메모리 업체가 아니라 AWS의 자체 칩 설계 조직인 안나푸르나랩스(Annapurna Labs)다.
여기서 한 가지는 구분해서 볼 필요가 있다.
안나푸르나랩스가 NVHBM의 첫 기술 협력사라는 것과 AWS의 차세대 Trainium이 NVLink Fusion을 지원한다는 것은 별개의 발표 내용이다.
엔비디아에 따르면 안나푸르나랩스는 NVHBM 기술과 NVLink 스케일업 아키텍처에서 엔비디아와 협력한다.
한편 AWS는 차세대 Trainium부터 NVLink Fusion을 지원하며 그 시작 제품으로 Trainium4가 지목됐다.
현재 공개된 내용만으로 Trainium4가 NVHBM을 탑재한다고 단정할 수는 없다.
오히려 중요한 것은 엔비디아의 전략이다.
AWS가 자체 AI 가속기를 만들더라도, 그 칩이 NVLink를 통해 연결되고 엔비디아의 랙 아키텍처와 메모리 기술을 활용한다면, 엔비디아는 커스텀 ASIC 시대에도 AI 인프라에서 영향력을 유지할 수 있다.
GPU를 반드시 엔비디아가 만들지 않아도 된다.
GPU 밖의 연결·메모리·랙 구조까지 엔비디아의 설계 자산이 들어간다면 이야기가 달라진다.
더 중요한 변화는 HBM의 ‘가치 귀속’이다
HBM 경쟁의 중심은 오랫동안 DRAM에 있었다.
몇 단을 쌓는지, 속도를 얼마나 높이는지, 용량을 얼마나 늘리는지, 발열과 수율을 어떻게 관리하는지가 중요했다.
하지만 HBM4 이후에는 베이스 다이의 역할이 빠르게 커지고 있다.
첨단 로직 공정을 사용하면서 베이스 다이에 더 복잡한 기능을 넣을 수 있게 됐기 때문이다.
NVHBM은 여기에서 한 단계 더 나아간다.
엔비디아는 자사의 커스텀 메모리 컨트롤러를 HBM 베이스 다이에 통합하고, 여러 메모리 공급업체가 검증·제공할 수 있는 멀티벤더 구조로 NVHBM을 확장하겠다고 밝혔다.
이 구조가 확대된다면 중요한 질문도 달라진다.
HBM이 고객사별 커스텀 제품으로 바뀔 때 가장 높은 부가가치는 누가 가져가게 될까.
DRAM을 만드는 메모리 업체일까.
베이스 다이를 생산하는 파운드리일까.
아니면 베이스 다이에 들어갈 핵심 기능과 인터페이스를 설계하는 XPU 업체일까.
삼성전자도 사흘 먼저 같은 문제를 꺼냈다
흥미로운 점은 엔비디아만 베이스 다이를 주목하고 있는 것이 아니라는 사실이다.
엔비디아 발표 사흘 전인 2026년 8월 23일, 삼성전자는 미국 스탠퍼드대에서 열린 Hot Chips 2026에서 HBM 베이스 다이를 활용해 AI 시스템의 구조를 바꾸는 방향을 제시했다.
다만 현재 삼성전자의 공식 보도자료나 전체 발표 자료가 공개된 것은 아니다. 이하 삼성의 Hot Chips 발표 내용은 현장을 취재한 서울경제 보도를 기준으로 한다.
보도에 따르면 삼성전자 메모리사업부 D램 디자인팀 한상욱 TL은 HBM 대역폭을 계속 높이는 과정에서 TSV와 PHY 입출력이 새로운 제약으로 등장하고 있다고 설명했다.
제한된 면적 안에서 데이터 통로를 계속 늘리는 데 한계가 있다는 것이다.
삼성이 제시한 방향 가운데 하나가 커스텀 HBM(cHBM)이다.
엔비디아나 AMD 같은 고객사가 사용하는 GPU와 NPU에 맞춰 베이스 다이를 설계하고, 속도나 전력 효율 등 필요한 기능만 강화하는 방식이다. PHY를 die-to-die 연결 구조로 바꿔 이런 커스텀 기능이 들어갈 공간을 만든다는 구상도 함께 제시됐다.
여기서 더 중요한 대목이 나온다.
GPU 안에 있던 메모리 제어 기능과 일부 AI 연산을 HBM 베이스 다이로 옮기는 구상이다.
엔비디아가 사흘 뒤 NVHBM에서 공개한 방향과 맞닿아 있다.
하지만 두 회사가 같은 곳을 바라본다고 해서 이해관계까지 같은 것은 아니다.
삼성전자 입장에서 베이스 다이는 메모리 업체가 첨단 로직 공정을 활용해 HBM 자체의 부가가치를 높일 수 있는 공간이다.
반면 엔비디아의 NVHBM에서 베이스 다이는 엔비디아가 설계한 메모리 컨트롤러와 커스텀 인터페이스가 들어가는 공간이다.
같은 베이스 다이를 바라보고 있지만 설계 주도권을 바라보는 위치가 다르다.
HBM이 표준 부품에서 고객별 커스텀 시스템으로 발전할수록 앞으로의 경쟁은 DRAM 성능만으로 결정되지 않을 가능성이 커지는 이유다.
누가 베이스 다이에 들어갈 기능을 정의하고 핵심 IP를 갖느냐가 HBM의 부가가치를 나누는 새로운 기준이 될 수 있다.
SK하이닉스도 이미 ‘메모리와 로직의 통합’을 말하고 있다
이 변화는 NVHBM 발표와 함께 갑자기 시작된 것도 아니다.
SK하이닉스는 2026년 4월 미국에서 열린 TSMC Technology Symposium에서 이미 ‘메모리와 로직의 통합’을 차세대 방향으로 제시했다.
당시 기조연설에 나선 안현 개발총괄(CDO)은 AI 가속기용 표준 HBM 공급을 넘어 고객 요구에 맞춘 커스텀 HBM으로 확대하겠다는 전략을 밝혔다.
특히 HBM4부터 베이스 다이에 TSMC의 첨단 로직 공정을 도입하는 것을 포함해 양사의 전략적 협력을 강화하겠다고 설명했다.
현장에 전시된 16단 48GB HBM4 제품 설명에도 ‘Powered by base die in TSMC advanced logic’이라는 문구가 사용됐다.
즉 HBM의 베이스 다이가 전통적인 메모리 공정의 영역을 넘어 로직 반도체와 파운드리의 영역으로 확장되는 변화는 이미 진행 중이다.
여기에 또 하나의 문제가 겹친다.
열이다.
SK하이닉스는 2026년 5월 26일 HBM 패키지 안에 통합 냉각 소자(ICE, Integrated Cooling Elements)를 넣는 iHBM 솔루션을 공개했다. 전기는 통하지 않으면서 열은 전달하는 실리콘 계열 소재를 패키지 내부에 배치해 열을 빼내는 구조이며, 회사는 이를 통해 열저항을 30% 낮춘다고 밝혔다. 시장에서 검증된 MR-MUF 기술을 활용해 기존 설계와의 호환성을 확보했다는 점도 함께 제시했다.
Hot Chips 2026 현장 취재 보도에 따르면, SK하이닉스는 이 냉각 구조를 베이스 다이에서 열이 가장 몰리는 die-to-die PHY 영역에 적용하는 방향을 설명했다. 인터페이스가 곧 발열의 집중 지점이기 때문이다.
이 대목이 중요한 이유는 베이스 다이의 역할이 단순히 메모리와 GPU를 연결하는 데서 끝나지 않기 때문이다.
대역폭을 높이기 위한 인터페이스, 고객별 기능을 넣기 위한 로직, 그리고 AI 가속기에서 발생하는 열을 제어하기 위한 구조까지.
서로 다른 문제가 베이스 다이라는 같은 공간으로 모이고 있다.
적층 기술도 이 변화와 연결된다.
서울경제 현장 취재에 따르면 SK하이닉스 아메리카의 이재식 부사장은 메모리를 20단으로 쌓기까지 넘어야 할 과제가 많다고 설명하며, HBM4E에 적용될지는 확실하지 않지만 하이브리드 본딩을 연구하고 있다고 밝혔다. 하이브리드 본딩은 중간 매개물 없이 칩 사이 금속 패드를 직접 연결하는 방식으로, 기존 기법보다 TSV 회로를 좁히고 HBM의 대부분을 차지하는 코어 다이의 두께를 24% 늘릴 수 있다는 설명이다.
즉 SK하이닉스가 바라보는 다음 HBM 역시 단순히 DRAM 속도를 높이는 문제로 끝나지 않는다.
로직 베이스 다이, 열 관리, 적층 방식, GPU·XPU, 파운드리와 패키징까지 함께 최적화해야 한다.
삼성전자는 커스텀 HBM과 첨단 로직 베이스 다이에서 답을 찾고 있고, SK하이닉스는 TSMC와의 로직 협력과 열 관리, 차세대 적층 기술까지 최적화 범위를 넓히고 있다.
그리고 엔비디아는 한 단계 더 들어와 그 베이스 다이에 들어갈 메모리 컨트롤러와 인터페이스 IP 자체를 설계하려 한다.
결국 세 회사가 서로 다른 문제를 풀고 있지만 향하고 있는 장소는 같다.
HBM의 가장 아래에 있는 베이스 다이다.
그렇다면 삼성전자와 SK하이닉스에는 위협일까
당장 NVHBM 때문에 삼성전자나 SK하이닉스의 HBM 사업이 약해진다고 보는 것은 지나치다.
오히려 엔비디아는 NVHBM을 여러 메모리 공급업체가 참여할 수 있는 멀티벤더 구조로 제시했다.
DRAM 생산과 적층, 패키징, 검증을 담당할 메모리 업체의 역할은 여전히 필요하다.
NVHBM이 실제 시장에 확대된다면 새로운 커스텀 HBM 수요가 만들어질 가능성도 있다.
하지만 장기적으로 살펴봐야 할 것은 협상력과 가치 배분이다.
과거에는 HBM 자체의 성능과 생산 능력이 제품 차별화의 상당 부분을 결정했다.
고객사가 베이스 다이에 들어갈 핵심 IP와 인터페이스를 직접 정의하고, 메모리 업체가 이를 생산·적층·검증하는 구조가 커진다면 경쟁의 기준은 달라질 수 있다.
메모리 업체의 경쟁력도 ‘누가 더 빠른 HBM을 만드느냐’에서 ‘누가 고객사의 커스텀 HBM을 가장 빠르고 안정적으로 구현할 수 있느냐’로 확대될 수 있다.
삼성전자는 메모리와 파운드리, 첨단 패키징을 모두 보유하고 있다는 점에서 이 변화를 하나의 기회로 만들 여지가 있다.
SK하이닉스는 HBM에서 확보한 기술 경쟁력에 TSMC와의 로직·패키징 협력을 결합하는 전략을 강화하고 있다.
어느 쪽이 더 유리한지는 아직 판단하기 이르다.
NVHBM 자체도 실제 상용 제품과 독립적인 성능 검증이 나오지 않았다.
다만 한 가지 변화는 분명하다.
HBM 경쟁의 경계가 메모리 업체 안에서 끝나지 않기 시작했다.
Keconowise View | 병목이 이동하자 설계권도 이동하기 시작했다
AI 반도체의 발전 과정을 보면 병목은 없어지지 않았다.
다른 곳으로 이동했다.
GPU의 연산 성능이 높아지자 데이터를 충분히 공급하지 못하는 메모리 병목이 커졌고 HBM의 중요성이 높아졌다.
HBM을 더 높게 쌓고 연결 밀도를 높이면서 TSV, 패키징, 하이브리드 본딩이 새로운 경쟁 영역으로 떠올랐다.
GPU가 수십 개에서 수백 개로 늘어나자 이번에는 GPU와 GPU, 서버와 서버 사이의 연결이 문제가 되면서 NVLink와 CPO가 중요해지고 있다.
그리고 이제 HBM 안에서도 같은 일이 벌어지고 있다.
베이스 다이가 단순한 받침대가 아니라 AI 시스템 설계의 일부가 되고 있다.
그래서 NVHBM에서 가장 중요한 숫자가 반드시 ‘대역폭 30%’나 ‘전력 15%’인 것은 아니다.
더 중요한 변화는 엔비디아가 메모리 컨트롤러를 HBM 안으로 옮기고 그 설계에 직접 들어가기 시작했다는 점이다.
삼성전자는 커스텀 HBM과 첨단 로직 베이스 다이에서 기회를 찾고 있다.
SK하이닉스는 메모리와 로직의 통합, TSMC와의 협력, 열 관리와 차세대 적층을 강조하고 있다.
그리고 엔비디아는 그 베이스 다이에 들어갈 핵심 IP 자체를 자신의 생태계로 가져오려 한다.
결국 HBM의 다음 경쟁에서 질문은 조금씩 바뀌고 있다.
누가 DRAM을 가장 잘 만드는가.
누가 가장 높게 쌓는가.
여기에 이제 하나가 더 붙는다.
누가 GPU·XPU·HBM·베이스 다이·패키징을 하나의 시스템으로 설계하고, 그 설계의 주도권을 가져갈 것인가.
다음으로 확인할 지점은 분명하다. 엔비디아가 아직 이름을 밝히지 않은 NVHBM 검증·공급 파트너로 어느 메모리 업체가 공식 확인되는지, 그리고 그 계약에서 베이스 다이 설계 IP의 귀속이 어떻게 정리되는지다.
NVHBM은 그 경쟁이 이미 시작됐다는 신호에 가깝다.