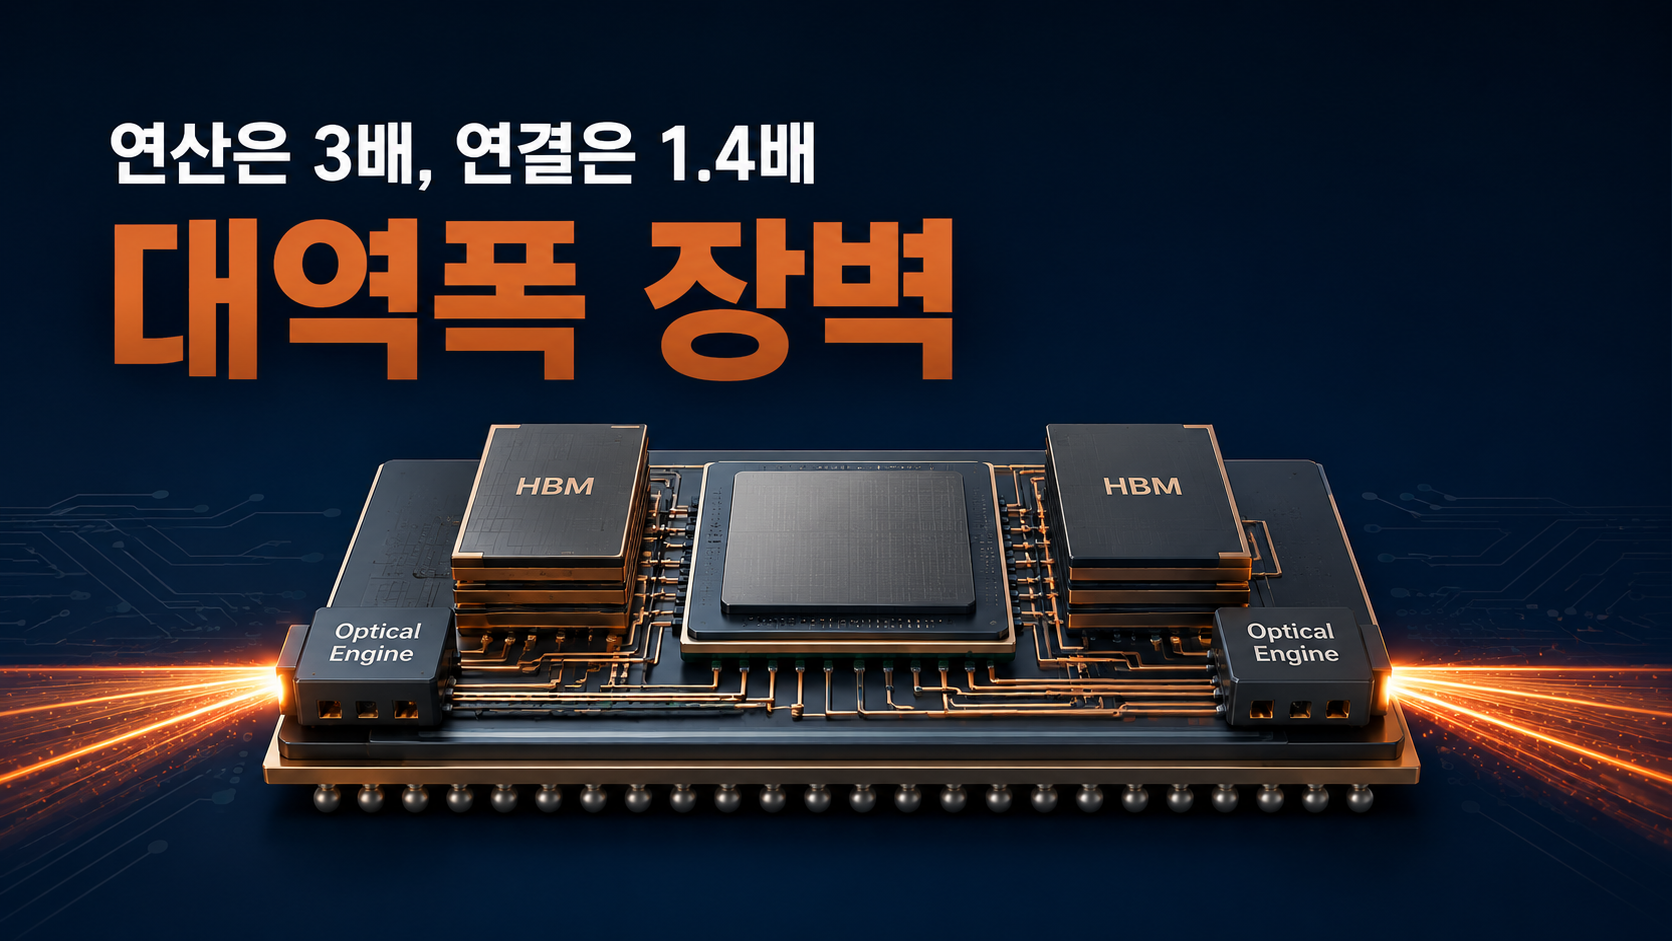
지난 몇 년간 AI 반도체 이야기의 중심에는 늘 HBM이 있었습니다.
GPU 바로 옆에 고대역폭 메모리를 배치해 데이터가 오가는 통로를 넓히면서, 연산장치가 데이터를 기다리는 ‘메모리 병목’을 크게 완화할 수 있었기 때문입니다.
그런데 AI 시스템의 규모가 커지면서 새로운 문제가 나타나고 있습니다. 바로 CPO(Co-Packaged Optics)가 해결하려는 ‘연결의 병목’입니다.
HBM으로 GPU 주변의 병목을 줄였더니, 이제는 GPU와 GPU, 서버와 서버를 연결하는 통로가 새로운 병목으로 떠오르고 있는 것입니다.
2026년 8월 19일 국제 학술지 『Nature Electronics』에는 이 문제를 다룬 리뷰 논문 「Co-packaged optics for high-performance computing and artificial intelligence」가 게재됐습니다.
이 논문은 버지니아대·연세대·MIT·UIUC·난양공대 연구진이 주도한 리뷰 논문이며, SK하이닉스에서는 홍승훈 AI 인프라 최적화 팀장이 교신저자 중 한 명으로 참여했습니다.
SK하이닉스는 다음 날인 8월 20일 뉴스룸을 통해 해당 연구의 주요 내용과 CPO 기술 로드맵을 소개했습니다.
메모리 기업의 연구자가 메모리 자체가 아니라 ‘데이터를 어떻게 이동시킬 것인가’를 다루는 연구에 참여했다는 점은 눈여겨볼 만합니다.
HBM이 완화한 문제, HBM이 해결하지 못한 문제
HBM은 AI 가속기 패키지 안쪽의 메모리 병목을 크게 완화한 기술입니다.
여러 개의 D램을 수직으로 쌓고 GPU 가까이에 배치해 기존 메모리보다 훨씬 넓은 데이터 통로를 확보합니다. 덕분에 GPU가 필요한 데이터를 더 빠르게 공급받을 수 있게 됐고, 생성형 AI 확산과 함께 HBM은 AI 가속기의 핵심 부품으로 자리 잡았습니다.
케코노와이즈에서도 앞서 HBM이 기존 메모리보다 훨씬 높은 대역폭을 만드는 원리와 AI가 왜 HBM을 필요로 하는지를 자세히 다뤘습니다.
관련 글: HBM은 왜 AI 반도체의 핵심 메모리가 됐을까?
문제는 최근의 AI 모델이 칩 한 장이나 서버 한 대에서 학습되지 않는다는 데 있습니다.
수천 개의 GPU가 랙(rack) 단위로 묶이고, 여러 랙이 다시 대규모 AI 클러스터를 구성합니다.
시스템 규모가 커질수록 GPU와 메모리 사이뿐 아니라 GPU와 GPU, 랙과 랙 사이에서 데이터를 얼마나 빠르게 이동시키느냐가 전체 성능을 좌우하게 됩니다.
SK하이닉스가 8월 20일 공개한 자료에 따르면 연산 처리량은 통상 2년마다 약 3배 증가한 반면, 인터커넥트 대역폭은 같은 기간 약 1.4배 증가하는 데 그쳤습니다.
연산 능력과 데이터 이동 능력 사이의 격차가 세대가 바뀔수록 벌어지고 있는 것입니다.
이를 업계에서는 대역폭 장벽(Bandwidth Wall)이라고 부릅니다.
결국 AI 인프라의 경쟁은 더 이상 GPU 한 장의 성능만으로 설명하기 어려워지고 있습니다.
왜 기존 전기 연결만으로는 부족할까
핵심 원인 가운데 하나는 기존 전기 인터커넥트의 물리적 한계입니다.
현재 칩과 서버, 랙 사이에서 데이터를 전달할 때는 구리 기반 전기 신호가 널리 사용됩니다. 짧은 거리에서는 비용과 효율 측면에서 여전히 경쟁력이 높습니다.
하지만 전송 속도가 빨라지고 거리가 길어질수록 상황이 달라집니다.
『Nature Electronics』 논문은 전기 인터커넥트에서 발생하는 저항 손실, 정전용량성 부하, 주파수에 따른 신호 왜곡이 대역폭과 지연시간, 에너지 효율을 제한한다고 설명합니다.
신호 손실을 보정하기 위한 회로가 추가되면 전력 소비와 지연도 함께 증가합니다.
GPU 자체의 연산 능력만 계속 높인다고 해서 AI 시스템 전체가 같은 속도로 빨라질 수 없는 이유입니다.
CPO는 무엇을 바꾸려는 기술인가
이 문제를 해결하기 위해 등장한 기술 가운데 하나가 CPO(Co-Packaged Optics·공동 패키징 광학)입니다.
CPO의 기본 아이디어는 광 엔진을 프로세서와 같은 패키지 안이나 최대한 가까운 위치에 배치하는 것입니다.
기존 구조에서는 데이터가 칩에서 나온 뒤 기판을 지나 광모듈까지 전기 신호로 이동하고, 그 이후에야 빛으로 변환됩니다.
CPO는 이 전기 구간을 크게 줄입니다.
전기 신호로 이동해야 하는 거리를 최소화하고 장거리 구간을 빛으로 전송함으로써 대역폭 밀도와 에너지 효율, 신호 무결성을 개선하려는 것입니다.
연구진이 제시한 차세대 AI 인프라의 기술 목표도 구체적입니다.
노드당 100Tb/s 이상의 대역폭, 1비트당 1피코줄(pJ) 미만의 에너지 소비, 칩 간 지연시간 10나노초 미만입니다.
또한 기술 발전 경로로 2D 구조에서 2.5D 인터포저 기반 통합을 거쳐 3D 이종집적으로 발전하는 방향을 제시했습니다.
이 지점에서 첨단 패키징의 역할도 달라집니다.
과거 패키징이 칩을 보호하고 전기적으로 연결하는 후공정에 가까웠다면, AI 시대에는 GPU와 HBM, 광소자처럼 서로 다른 부품을 하나의 시스템으로 통합하는 핵심 기술이 되고 있습니다.
더 멀리 가면 메모리까지 빛으로 연결한다
연구진이 바라보는 미래는 단순히 네트워크 연결을 빛으로 바꾸는 데서 끝나지 않습니다.
장기적으로는 광 연결을 메모리 인터페이스까지 확대하는 ‘옵틱스 중심(optics-centric)’ 구조도 제안합니다.
포토닉 인터포저를 통해 프로세서와 메모리 자원을 직접 연결하고, 여러 AI 가속기가 하나의 대규모 메모리 풀을 공유하는 방식입니다.
현재 HBM은 GPU 패키지 주변의 물리적 공간과 전력, 열 설계의 제약을 받습니다.
AI 모델이 커질수록 더 많은 메모리가 필요하지만, 패키지 주변에 HBM을 무한정 배치할 수는 없습니다.
광 연결을 통해 떨어져 있는 메모리 자원까지 보다 효율적으로 공유할 수 있다면 AI 시스템의 메모리 구조 자체가 달라질 가능성이 있습니다.
다만 이 부분은 현재 완성된 상용 구조라기보다 CPO가 더 발전했을 때 가능한 장기적인 시스템 아키텍처로 보는 것이 정확합니다.
CPO는 어디까지 왔을까
CPO를 먼 미래의 연구실 기술로만 보기도 어렵습니다.
시장조사업체 TrendForce는 2026년 7월 분석에서 엔비디아가 차세대 Spectrum-X CPO 스위치를 일부 파트너에 출하하기 시작했고, 브로드컴의 51.2T Bailly CPO 스위치도 양산 단계에 들어갔다고 설명했습니다.
엔비디아의 Spectrum-X CPO 스위치는 TSMC의 COUPE 첨단 패키징 기술을 사용하며 최대 400Tb/s의 스위칭 용량을 제공한다고 TrendForce는 설명합니다.
그러나 제한적인 출하가 시작됐다는 것과 대규모 확산이 이뤄졌다는 것은 다른 이야기입니다.
TrendForce는 CPO 스위치 시장의 본격적인 물량 확대가 2027~2028년 진행될 가능성을 제시하고 있습니다.
즉 CPO는 실험실을 벗어나 상용화 단계에 진입하고 있지만, 아직 대규모 공급망이 완성된 기술은 아닙니다.
상용화를 가로막는 세 가지 벽
첫 번째는 열 관리와 광 엔진 수율입니다.
광 엔진에는 레이저, 변조기, 광검출기와 광결합 부품 등이 함께 들어갑니다. 구조가 복잡하기 때문에 높은 제조 수율을 확보해야 하고, 동시에 열을 안정적으로 제어해야 합니다.
『Nature Electronics』 논문 역시 열 관리를 CPO가 해결해야 할 핵심 과제로 꼽고 있습니다.
두 번째는 실리콘 포토닉스 생산능력입니다.
TrendForce는 실리콘 포토닉스 웨이퍼 생산과 첨단 패키징에 높은 정밀도와 신뢰성이 필요하며, 생산능력을 확대하는 데 시간이 오래 걸린다는 점을 지적합니다.
세 번째는 첨단 패키징 캐파입니다.
CPO 스위치가 TSMC의 COUPE 같은 기술에 의존하게 되면 AI GPU와 HPC 프로세서가 사용하는 것과 동일한 2.5D·3D 패키징 자원을 두고 경쟁하게 됩니다.
결국 CPO가 AI 인프라의 병목을 해결하기 위해 등장했지만, CPO 자체도 다시 첨단 패키징 생산능력이라는 새로운 병목에 부딪힐 수 있는 셈입니다.
『Nature Electronics』 논문은 여기에 제조 가능성과 표준화까지 주요 과제로 제시합니다.
따라서 CPO 경쟁도 이제 기술이 작동하느냐를 넘어 얼마나 안정적으로, 충분한 물량을, 합리적인 비용으로 생산할 수 있느냐의 문제로 이동하고 있습니다.
Keconowise View: AI 반도체의 병목은 계속 이동한다
이번 CPO 논문에서 가장 흥미로운 부분은 특정 기술 하나가 아니라 AI 산업의 병목이 이동하는 과정입니다.
처음에는 연산 능력이 부족했습니다.
GPU 성능이 빠르게 높아지자 데이터를 공급하는 메모리가 병목으로 떠올랐고, HBM이 중요해졌습니다.
HBM이 메모리 대역폭을 크게 높이자 이제는 수천 개의 AI 가속기를 연결하는 인터커넥트와 전력 효율이 새로운 제약으로 부상하고 있습니다.
그래서 CPO가 등장했습니다.
그런데 CPO의 생산이 늘어나면 다시 광 엔진 수율, 실리콘 포토닉스 생산능력, 첨단 패키징 캐파가 병목이 될 수 있습니다.
이 흐름을 보면 AI 반도체 산업의 경쟁이 단순히 ‘가장 빠른 GPU를 누가 만드느냐’에서 멀어지고 있다는 점을 알 수 있습니다.
이제 중요한 것은 연산·메모리·인터커넥트·패키징을 하나의 시스템으로 얼마나 효율적으로 설계하느냐입니다.
SK하이닉스 홍승훈 팀장도 회사 뉴스룸에서 메모리를 독립된 부품이 아니라 고객의 AI 경쟁력을 결정하는 더 큰 시스템 아키텍처의 일부로 보고 있다고 설명했습니다.
메모리 기업 입장에서도 의미가 있습니다.
HBM 이전에는 범용 메모리의 생산능력과 원가 경쟁력이 중요했다면, HBM에서는 GPU·ASIC 고객과 설계 단계부터 협력하고 첨단 패키징과 열 관리까지 함께 고려해야 합니다.
CPO까지 연결되면 관심 영역은 메모리 칩 한 개에서 AI 시스템 전체의 데이터 이동 구조로 더 넓어집니다.
다만 이것이 CPO가 HBM을 대체한다거나 메모리 기업이 곧바로 새로운 가격 결정권을 갖게 된다는 뜻은 아닙니다.
더 중요한 메시지는 따로 있습니다.
AI 반도체 산업에서 병목은 사라지는 것이 아니라 계속 다른 곳으로 이동하고 있다는 것입니다.
그래서 앞으로 AI 반도체를 볼 때는 개별 GPU의 성능 수치만큼이나 이런 질문이 중요해질 수 있습니다.
수천 개의 GPU를 하나의 시스템으로 묶었을 때, 다음 병목은 어디에서 발생할 것인가.