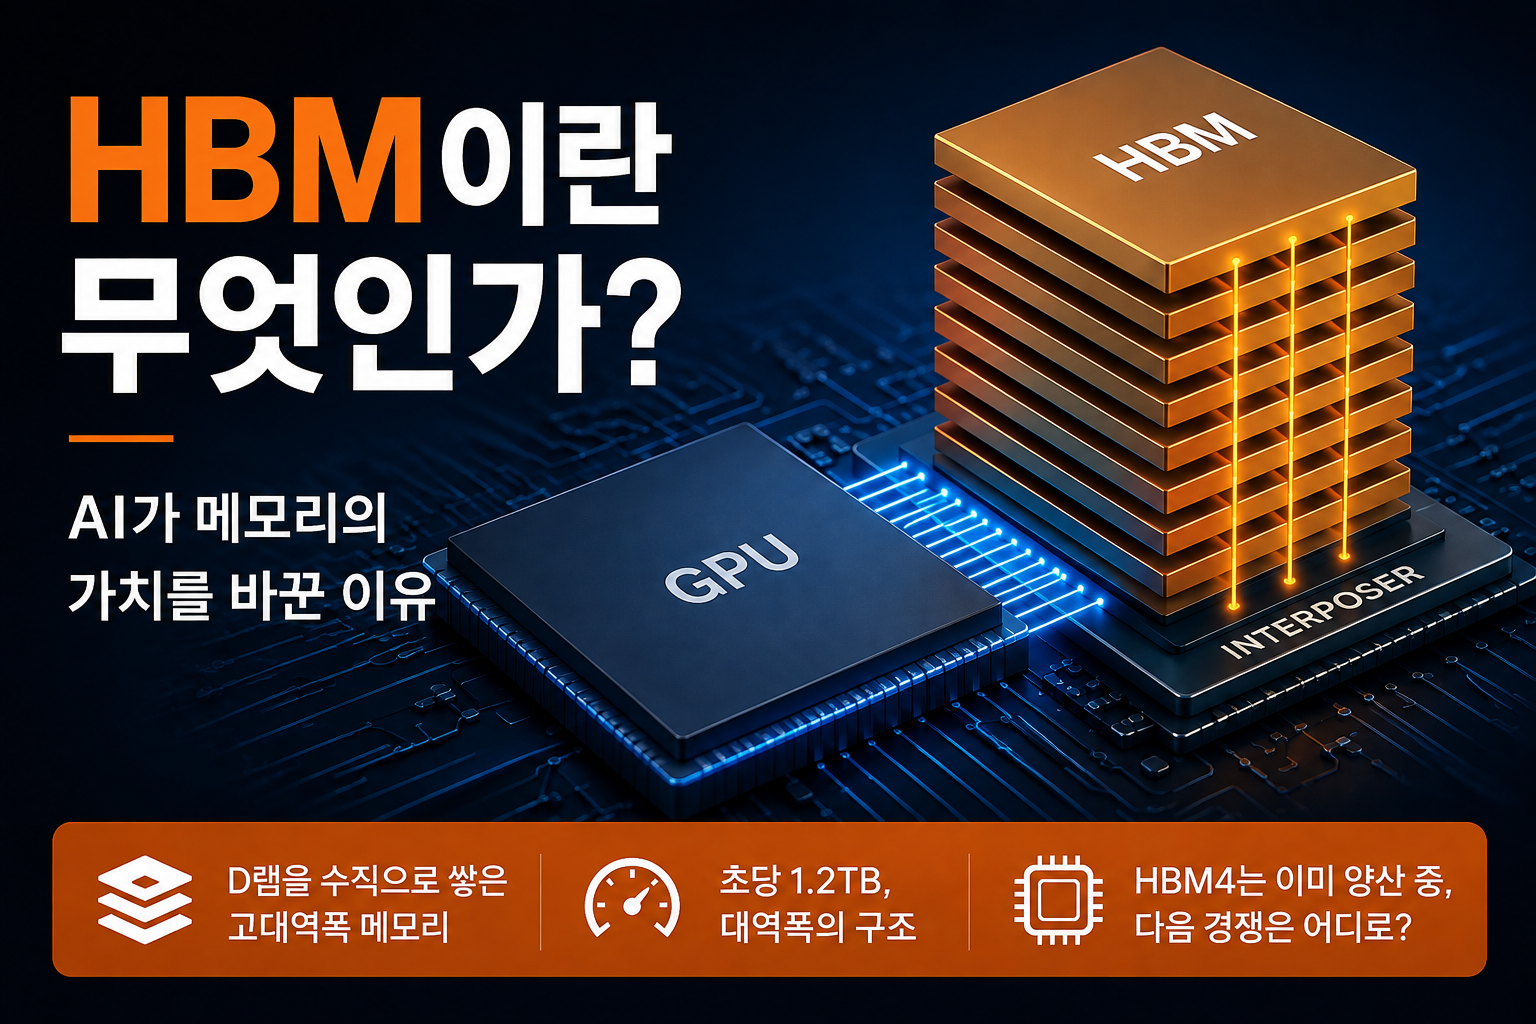
일반적인 서버용 DDR5 메모리는 채널당 초당 수십 GB 수준의 데이터를 전송하는 반면, 최신 HBM3E는 하나의 스택에서 초당 1TB가 넘는 데이터를 처리한다. Micron의 HBM3E는 스택당 1.2TB/s 이상, 삼성전자의 36GB HBM3E 12H는 최대 1,280GB/s의 대역폭을 제시한다. 다만 DDR5와 HBM은 채널 구성과 인터페이스 구조 자체가 다르기 때문에 이를 단순히 일대일 성능 비교로 볼 수는 없다.
오히려 중요한 질문은 따로 있다.
HBM은 어떻게 기존 메모리보다 훨씬 넓은 데이터 통로를 만들었고, AI는 왜 이 정도의 대역폭을 필요로 하게 됐을까.
그 답은 연산장치의 발전 속도를 메모리의 데이터 공급 능력이 따라가지 못하는 메모리 월(memory wall)에서 시작한다.
이하 제품 성능과 기술 수치는 별도 표기가 없는 경우 삼성전자·SK하이닉스·Micron 등 각 사 공식 발표 및 제품 자료를 기준으로 한다.
연산이 빨라져도 시스템 전체가 빨라지지 않는 이유
컴퓨터는 연산장치와 메모리가 데이터를 끊임없이 주고받으며 작동한다.
문제는 두 영역의 발전 속도가 항상 같지 않다는 것이다.
GPU와 AI 가속기는 수많은 연산을 동시에 처리할 수 있도록 발전했다. 그러나 연산에 필요한 데이터를 메모리에서 충분히 빠르게 가져오지 못하면 GPU는 다음 계산을 기다려야 한다.
고속도로의 차선을 계속 늘렸는데 진입로가 좁아 차량이 충분히 들어오지 못하는 것과 비슷하다.
이처럼 연산 성능이 높아져도 메모리의 데이터 공급 능력이 이를 따라가지 못해 시스템 성능을 제한하는 현상을 흔히 메모리 월이라고 부른다.
AI 시대에는 이 문제가 더욱 중요해졌다.
대규모 AI 모델은 수많은 파라미터와 중간 데이터를 반복적으로 읽고 써야 한다. GPU가 한 번에 처리할 수 있는 계산량이 늘어날수록 그 계산에 필요한 데이터를 공급하는 메모리의 역할도 커진다.
AI 반도체 경쟁이 이제 얼마나 빨리 계산할 수 있는가뿐 아니라 얼마나 많은 데이터를 빠르게 연산장치까지 전달할 수 있는가의 경쟁이 된 이유다.

HBM은 메모리 병목을 어떻게 우회했나
HBM은 High Bandwidth Memory, 즉 고대역폭 메모리다.
기존 메모리는 여러 개의 D램을 기판 위에 배치하고 배선을 통해 프로세서와 연결하는 방식이 일반적이다. 처리해야 할 데이터가 많아질수록 배선의 수와 길이, 소비전력 등의 물리적 제약도 커진다.
HBM은 이 문제에 다른 방식으로 접근했다.
D램을 옆으로 계속 늘어놓는 대신 위로 쌓았다.
여기서 핵심 기술이 TSV(Through-Silicon Via·실리콘 관통 전극)다.
TSV는 얇게 가공한 D램을 수직으로 관통하는 전기적 연결 통로를 만들어 위아래 다이를 연결한다. 여러 개의 D램을 위로 적층하면서도 매우 많은 데이터 통로를 확보할 수 있다.
삼성전자 HBM3E 12H의 경우 12개의 D램을 TSV 기반으로 적층하고 1,024개의 I/O로 구성된 넓은 인터페이스를 사용한다. 최대 데이터 처리 속도는 1,280GB/s다.
핵심은 개별 핀 하나를 무작정 빠르게 만드는 것이 아니다.
HBM은 매우 넓은 인터페이스를 만들어 한 번에 이동시킬 수 있는 데이터의 양을 크게 늘린다.
여기에 인터포저(interposer)가 중요한 역할을 한다.
AI 가속기 패키지를 보면 GPU 바로 옆에 여러 개의 HBM 스택이 배치된다. 이렇게 가까이 붙이는 이유는 수많은 신호를 짧은 거리에서 주고받기 위해서다.
인터포저는 GPU와 HBM 사이에 고밀도 배선을 제공한다. 기존 기판보다 훨씬 촘촘한 연결을 구현함으로써 GPU와 여러 HBM 스택이 넓은 인터페이스로 데이터를 주고받을 수 있도록 한다.
결국 HBM의 높은 대역폭은 D램을 위로 쌓는 것만으로 완성되지 않는다.
TSV를 이용한 수직 연결, 넓은 메모리 인터페이스, GPU와 HBM을 가깝게 연결하는 첨단 패키징 구조가 함께 작동해야 한다.

일반 D램의 평면 배치와 TSV 기반 HBM 적층 구조 비교
AI 학습과 추론에서 HBM이 중요한 이유
AI 학습에서는 대규모 데이터를 반복적으로 처리하면서 수많은 파라미터를 업데이트한다. 따라서 연산 능력뿐 아니라 메모리 용량과 대역폭 모두 중요하다.
추론에서는 병목이 조금 다르게 나타난다.
대규모 언어모델이 토큰을 생성하는 과정에서는 모델 가중치와 여러 데이터를 지속적으로 메모리에서 읽어야 한다. 특히 메모리 대역폭에 민감한 추론 구간에서는 HBM 성능이 토큰 처리량과 응답 성능을 좌우하는 주요 변수 가운데 하나가 된다.
물론 추론 성능이 HBM 하나로 결정되는 것은 아니다.
모델 크기와 배치 크기, GPU 연산 성능, KV 캐시, 소프트웨어 최적화 등 여러 요소가 함께 작용한다. 그러나 메모리에서 데이터를 충분히 빠르게 공급하지 못한다면 높은 연산 능력을 갖춘 GPU도 성능을 온전히 활용하기 어렵다.
Micron은 HBM3E를 적용한 자사 기술 분석에서 특정 LLM 추론 환경에서 기존 HBM3 기반 구성보다 최대 약 1.8배의 처리량 향상이 가능하다고 제시했다. 특정 시스템을 이용한 제조사 자체 벤치마크이므로 모든 AI 환경에 그대로 적용할 수 있는 수치는 아니지만, 메모리 용량과 대역폭이 실제 AI 추론 성능에 영향을 미칠 수 있다는 사례로 볼 수 있다.
용량 역시 중요하다.
모델과 작업에 필요한 데이터가 가속기의 메모리에 충분히 들어가지 않으면 다른 메모리 계층이나 여러 가속기 사이에서 데이터를 이동시켜야 할 수 있다. 데이터 이동이 늘어나면 지연과 전력 소비도 커진다.
AI 시대의 메모리는 데이터를 저장하는 창고에만 머물지 않는다.
GPU가 쉬지 않고 계산할 수 있도록 데이터를 공급하는 핵심 인프라로 역할이 바뀌고 있다.
관련 글: 「AI 추론 칩 전쟁 — 토큰당 비용」 내부링크 삽입
HBM은 왜 만들기 어려운가
HBM의 기본 아이디어는 어렵지 않다.
여러 개의 D램을 쌓고 수많은 통로로 연결하면 된다.
어려운 것은 이것을 대량 생산하면서 높은 수율을 유지하는 일이다.
HBM 제조에서는 먼저 개별 D램을 검사해 양품 다이, 이른바 KGD(Known Good Die)를 선별한다. 문제는 그다음이다. 이미 정상으로 확인된 여러 개의 다이를 쌓는 과정에서 TSV 연결, 정렬, 열압착과 같은 적층·접합 공정에 문제가 생기면 그동안 투입한 양품 다이와 공정 가치가 함께 손실될 수 있다.
적층 수가 높아질수록 한 번의 공정 실패에 걸리는 가치도 커진다. 8단보다 12단, 12단보다 더 높은 적층으로 갈수록 정밀한 정렬과 접합 품질을 유지해야 할 지점이 많아지고 패키지 휨과 열 문제까지 동시에 관리해야 한다.
따라서 HBM 수율은 단순히 좋은 D램을 몇 개 만들 수 있느냐의 문제가 아니다. 이미 검증된 다이를 얼마나 안정적으로 적층하고 하나의 고가 스택으로 완성할 수 있느냐가 핵심이다.
이 때문에 최신 장비를 도입하는 것만으로 단기간에 경쟁력을 확보하기 어렵다. D램 제조부터 TSV, KGD 선별, 적층, 본딩, 열 관리와 테스트까지 여러 공정에서 축적된 노하우가 동시에 필요하기 때문이다.
TC-NCF와 MR-MUF, 다른 방식으로 푸는 적층 문제
적층 수가 증가하면서 본딩 방식도 중요한 경쟁 요소가 됐다.
삼성전자는 HBM3E 12H에 Advanced TC-NCF를 적용했다.
TC-NCF는 비전도성 필름을 이용하면서 열과 압력으로 칩을 접합하는 방식이다. 삼성전자는 칩 사이 간격을 약 7마이크로미터까지 줄여 12단 제품을 기존 8단 제품과 같은 높이로 구현했다고 밝혔다.
SK하이닉스는 Advanced MR-MUF를 활용한다.
MR-MUF는 적층된 칩을 연결한 뒤 칩 사이 공간을 보호 소재로 채우는 방식이다. SK하이닉스는 이 기술을 통해 생산성과 열 방출 특성을 개선해 왔다.
적층이 높아질수록 열 문제도 커진다.
좁은 공간에 여러 개의 D램을 쌓으면 내부에서 발생한 열을 외부로 빼내기 어려워진다. 여기에 GPU 자체의 소비전력까지 높아지면서 HBM의 열 관리는 AI 가속기 전체 성능과 안정성에 영향을 미치는 문제가 됐다.
SK하이닉스가 2026년 5월 공개한 iHBM도 이 문제를 겨냥한다. 회사는 HBM 패키지 내부에 냉각 구조를 통합해 기존 방식보다 열저항을 30% 이상 낮추는 것을 목표로 하고 있으며, HBM5를 포함한 차세대 제품 적용을 계획하고 있다.
HBM 경쟁이 더 이상 D램 미세공정만의 경쟁이 아닌 이유다.
다음 단계로 거론되는 하이브리드 본딩
적층 수가 계속 늘어나면서 기존 범프 기반 접합을 넘어서는 기술도 주목받고 있다.
대표적인 것이 하이브리드 본딩(hybrid bonding)이다.
기존 HBM에서는 미세한 범프를 이용해 위아래 칩을 연결하지만, 하이브리드 본딩은 칩의 금속 배선과 절연층을 직접 접합하는 방향으로 발전하고 있다. 칩 사이 거리를 줄이고 연결 밀도를 높일 수 있으며 고단 적층에서 전체 패키지 두께를 낮추는 데에도 유리할 수 있지만, 접합면의 평탄도와 청정도, 정렬 정밀도, 생산성과 비용 등 해결해야 할 과제도 남아 있다.
따라서 기존 본딩 기술의 고도화와 하이브리드 본딩의 상용화 검토가 당분간 함께 진행될 가능성이 크다.
여기서 HBM과 첨단 패키징의 경계는 더욱 흐려진다.
HBM4는 이미 양산 단계, 경쟁은 HBM4E로 이동한다
HBM4는 더 이상 미래 제품이 아니다.
Micron은 2026년 1분기부터 36GB 12단 HBM4 양산 출하를 시작했다. NVIDIA Vera Rubin 플랫폼을 겨냥한 제품으로, 2,048개의 I/O와 핀당 11Gbps 이상의 속도를 이용해 스택당 2.8TB/s 이상의 대역폭을 제공한다.
Micron은 자사 HBM3E와 비교해 대역폭이 약 2.3배 높고 전력 효율은 20% 이상 개선됐다고 밝혔다. 48GB 용량의 16단 HBM4 샘플도 고객사에 출하했다.
SK하이닉스도 HBM4 양산 단계에 들어갔다.
회사는 2026년 7월 실적 컨퍼런스콜에서 주요 고객사향 HBM4를 2분기부터 양산 공급하기 시작했으며 하반기부터 공급량을 본격 확대할 계획이라고 밝혔다. 동시에 차세대 HBM4E 개발도 진행하고 있다.
SK하이닉스가 6월 공급한 12단 HBM4E 고객 샘플은 48GB 용량으로 핀당 최대 16Gbps를 구현했다. 회사 발표 기준 HBM4 대비 에너지 효율은 20% 이상 개선되고 열저항은 약 17% 낮아졌다.
삼성전자 역시 HBM4를 차세대 AI 메모리 전략의 핵심 제품으로 개발하면서 시장 경쟁에 참여하고 있다. 세 회사의 구체적인 고객 인증과 공급 상황, 기술 전략에는 차이가 있지만 HBM 시장의 경쟁축이 HBM3E에서 HBM4, 그리고 HBM4E로 이동하고 있다는 방향 자체는 분명하다.
특히 HBM4 세대부터 주목해야 할 변화가 베이스 다이(base die)다.
HBM 스택 가장 아래에 위치하는 베이스 다이의 기능이 복잡해지면서 단순한 메모리 공정을 넘어 로직 반도체 제조 기술의 중요성이 커지고 있다. 고객별 AI 가속기에 최적화된 커스텀 베이스 다이가 확대되면 메모리 업체와 파운드리, 패키징 업체의 협력 구조도 지금보다 복잡해질 수 있다.
과거 HBM 경쟁에서 좋은 D램을 만들고 안정적으로 쌓는 능력이 중요했다면 앞으로는
메모리 공정 + 로직 베이스 다이 + 본딩 + 열 관리 + 첨단 패키징
을 하나의 시스템으로 통합하는 능력이 더욱 중요해질 가능성이 있다.
AI 시대가 메모리의 가치를 바꿨다는 말도 결국 여기로 연결된다.
과거 메모리 산업의 핵심 질문이
“얼마나 많은 데이터를 저장할 수 있는가”
였다면, AI 시대에는 또 하나의 질문이 붙었다.
“그 데이터를 얼마나 빠르고 효율적으로 연산장치까지 전달할 수 있는가.”
HBM은 이 질문에 대한 반도체 산업의 답 가운데 하나다.
그리고 HBM4가 이미 양산되고 HBM4E 경쟁이 시작된 지금, 다음 질문은 더 복잡해지고 있다.
HBM 경쟁력을 결정하는 것은 D램 기술일까. 본딩과 열 관리일까. 로직 베이스 다이일까. 아니면 이 모든 기술을 하나의 AI 패키지로 묶어내는 능력일까.
이 질문이 삼성전자와 SK하이닉스의 실제 HBM 경쟁에서 어떻게 나타나고 있는지는 관련 글에서 이어서 살펴본다.
관련 글
- HBM 전쟁, SK하이닉스는 왕좌를 지킬 수 있을까
- 삼성 vs SK하이닉스, HBM 다음 전쟁터는 어디인가
주요 참고자료
- Samsung Semiconductor — HBM3E 12H 및 HBM 기술 자료
- SK hynix Newsroom — HBM4·HBM4E·Advanced MR-MUF·iHBM 관련 자료
- Micron Technology — HBM3E·HBM4 제품 및 기술 자료
- JEDEC — High Bandwidth Memory 관련 표준 자료
본 글은 반도체 산업과 기술 구조를 이해하기 위한 정보 제공을 목적으로 하며 특정 기업의 주식 매수·매도를 권유하지 않습니다.