AI 반도체 이야기는 보통 칩에서 끝난다.
몇 나노 공정인지, HBM을 몇 단 쌓았는지, 연산 성능이 몇 배 높아졌는지가 관심의 중심이다.
그런데 AI 데이터센터의 규모가 커지면서 다른 문제가 빠르게 부상하고 있다.
이제 문제는 GPU를 구하는 것만이 아니다.
그 GPU를 돌리는 데 필요한 전력을 제때 확보할 수 있느냐가 새로운 병목으로 떠오르고 있다.
국제에너지기구(IEA)는 전 세계 데이터센터의 전력 소비가 2030년까지 지금보다 두 배 이상 늘어날 것으로 전망한다. 더 큰 문제는 속도의 차이다.
데이터센터는 2~3년 안에도 구축할 수 있지만 발전·송전·변전 인프라는 계획부터 건설까지 훨씬 긴 시간이 필요하다.
칩의 시간과 전력망의 시간이 달라지고 있다.
랙 하나가 작은 데이터센터가 되는 과정
AI 서버는 여러 장비를 세로로 쌓은 랙(rack) 단위로 구축된다.
과거 데이터센터에서는 랙 하나의 전력 밀도가 수 kW에서 수십 kW 수준인 경우가 일반적이었다.
그런데 GPU가 랙 전체를 하나의 거대한 컴퓨팅 시스템처럼 묶는 방향으로 발전하면서 상황이 빠르게 달라지고 있다.
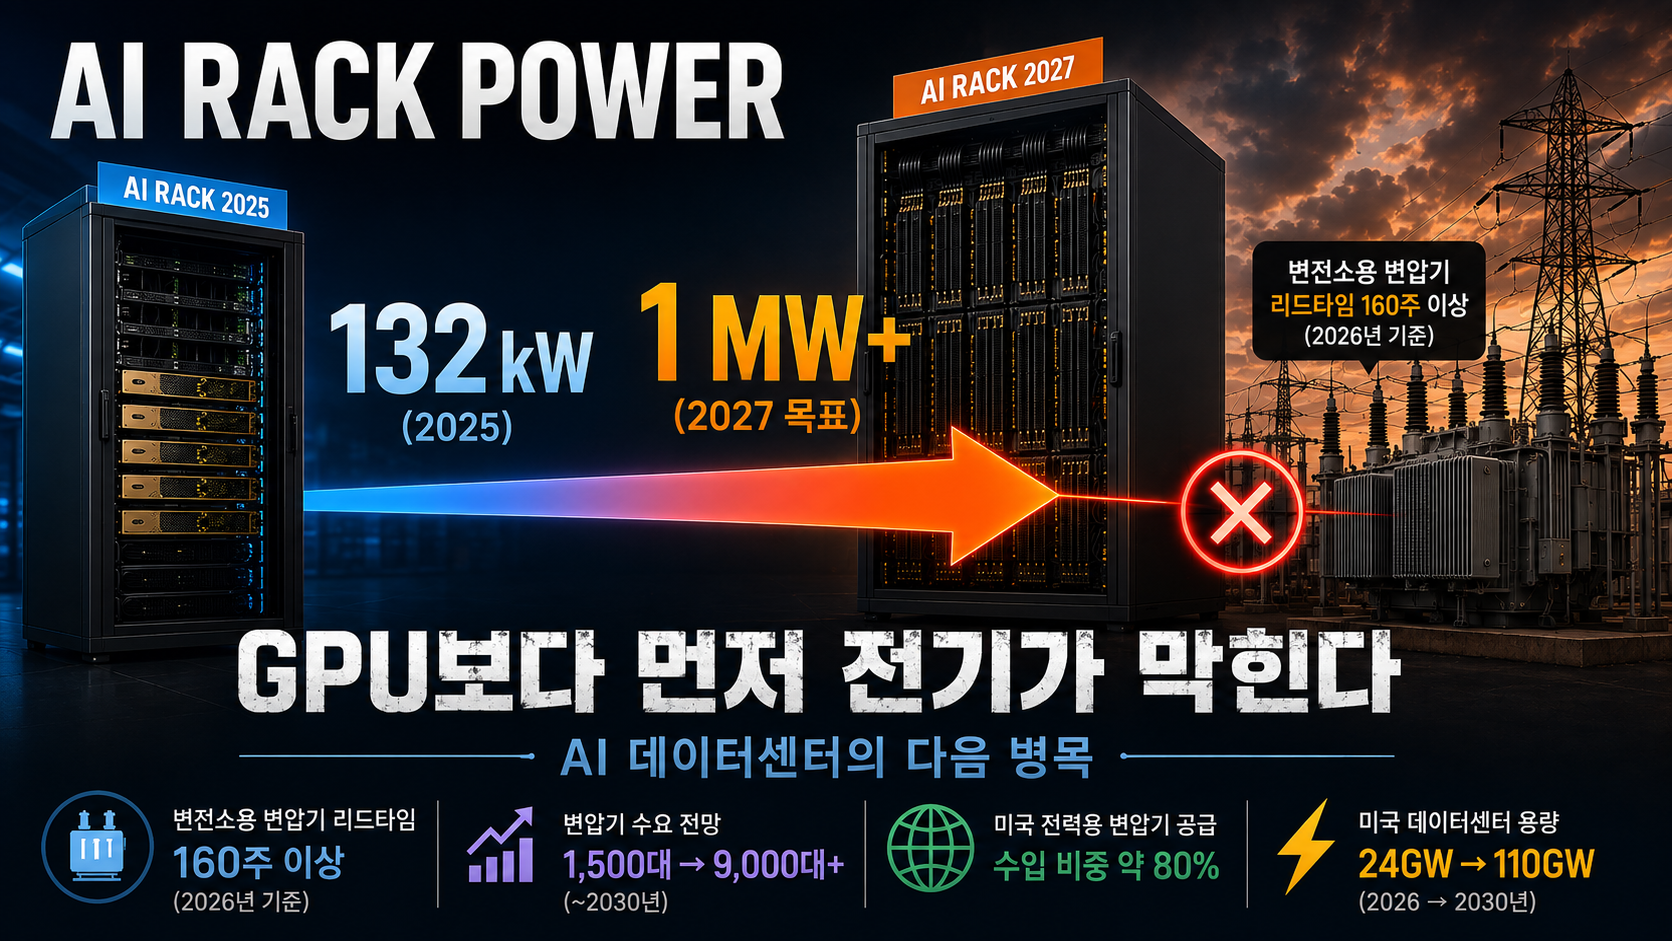
HPE가 공개한 NVIDIA GB300 NVL72 시스템의 랙당 명목 TDP는 132kW다. 전기적 피크 설계전력은 약 155kW이며, HPE는 데이터센터 버스웨이가 192kW까지 대응할 수 있도록 준비할 것을 권고한다.
그런데 엔비디아가 2027년부터 준비하는 것은 1MW 이상의 IT 랙이다.
단순 비교하면 132kW에서 1MW 이상으로, 불과 몇 년 사이 랙 하나가 감당해야 할 전력 규모가 7배 이상으로 커지는 셈이다.
중요한 것은 정확히 몇 배냐보다 방향이다.
AI 컴퓨팅의 전력 밀도가 서버를 더 많이 꽂는 수준을 넘어 데이터센터의 전력 배전 구조 자체를 다시 설계해야 하는 단계로 들어가고 있다.
AI 데이터센터는 더 이상 서버를 많이 모아놓은 건물만으로 보기 어렵다.
점점 거대한 전력 설비에 가까워지고 있다.
전기는 GPU에 도달하기까지 여러 번 모습을 바꾼다
여기서 첫 번째 반도체 문제가 나온다.
전력망에서 들어온 전기가 GPU 내부의 트랜지스터까지 도달하려면 여러 차례 전압 변환을 거친다.
고압 교류를 받아 변압하고, 교류를 직류로 바꾸고, 랙 내부에서 다시 낮은 전압으로 내린 뒤 마지막에는 GPU가 사용하는 낮은 전압까지 변환해야 한다.
문제는 전력 변환에는 손실이 따른다는 것이다.
랙 전력이 작을 때는 이런 손실을 상대적으로 관리하기 쉬웠다.
하지만 랙 하나가 100kW를 넘어 메가와트급으로 향하면 전력 공급 구조 자체가 문제가 된다.
특히 전압이 낮으면 같은 전력을 전달하기 위해 훨씬 큰 전류가 필요하다.
전력의 기본 관계는 간단하다.
전력 = 전압 × 전류
같은 1MW를 전달한다고 생각해보자.
54V에서는 약 18,500A가 필요하지만 800V에서는 약 1,250A면 된다.
전류가 줄어들면 굵은 구리 도체에 대한 요구도 줄고 저항에 따른 손실과 발열을 관리하기도 쉬워진다.
그래서 엔비디아가 꺼낸 답이 800V 직류(800 VDC)다.
기존 54V 랙 내부 배전은 kW급 랙을 기준으로 만들어졌다. 엔비디아는 앞으로 등장할 MW급 AI 랙을 지원하기 위해 2027년부터 800V 직류 기반 데이터센터 전력 인프라로 전환한다는 계획을 공개했다.
엔비디아는 이 구조가 엔드투엔드 전력 효율을 최대 5% 개선하고 총소유비용(TCO)을 최대 30% 절감할 수 있다고 설명한다.
AI 반도체 경쟁이 이제 칩의 연산 성능뿐 아니라 칩까지 전기를 얼마나 효율적으로 전달하느냐로 확장되고 있는 것이다.
800V 시대가 열리면 전력반도체도 달라진다
이 변화는 전력설비 회사만의 이야기가 아니다.
결국 높은 전압을 GPU가 사용할 수 있는 낮은 전압으로 바꾸는 과정에는 전력반도체가 필요하다.
그리고 전압과 전력 밀도가 높아질수록 변환 효율과 발열, 스위칭 손실이 중요해진다.
이 때문에 기존 실리콘 기반 전력반도체뿐 아니라 SiC(탄화규소)와 GaN(질화갈륨) 같은 와이드밴드갭 반도체가 AI 데이터센터의 전력 시스템에서도 중요한 기술 후보로 거론된다.
엔비디아가 공개한 800V 생태계에는 Analog Devices, Infineon, onsemi, Renesas, ROHM, STMicroelectronics, Texas Instruments 같은 반도체 업체와 Eaton, Schneider Electric, Vertiv 등 전력 인프라 업체가 함께 참여하고 있다.
이 구성이 의미하는 바는 분명하다.
AI 붐이 만드는 반도체 수요는 GPU와 HBM에서 끝나지 않는다.
GPU에 전력을 공급하기 위한 전력반도체와 전력변환 시스템까지 같은 생태계 안으로 들어오고 있다.
열은 전력 문제의 다른 얼굴이다
GPU에 들어간 전력은 연산을 수행한 뒤 결국 대부분 열로 바뀐다.
따라서 랙 전력 밀도가 올라가면 냉각 문제도 동시에 커진다.
HPE의 GB300 NVL72 시스템 역시 높은 전력 밀도를 처리하기 위해 액체 냉각을 사용하며, HPE가 제시한 CDU(Cooling Distribution Unit)는 최대 8개 랙을 지원하고 1.3MW의 냉각 용량을 갖는다.
여기서 놓치기 쉬운 부분이 있다.
냉각 장비 역시 전기를 사용한다.
데이터센터에서는 이를 이해하기 위해 PUE(Power Usage Effectiveness)라는 지표를 많이 사용한다.
PUE는 시설 전체 소비전력을 IT 장비의 소비전력으로 나눈 값이다.
예를 들어 PUE가 1.5라면 IT 장비가 1kW를 사용할 때 데이터센터 전체에서는 1.5kW가 필요하다는 의미다.
따라서 냉각과 전력변환 효율을 높이는 것은 단순히 전기요금을 줄이는 문제가 아니다.
같은 전력망 용량으로 GPU를 몇 대 더 돌릴 수 있느냐의 문제다.
전력 공급이 희소해질수록 냉각 효율은 곧 컴퓨팅 용량이 된다.
진짜 벽은 데이터센터 건물 밖에 있다
지금까지는 데이터센터 내부의 문제였다.
하지만 더 어려운 병목은 건물 밖에 있다.
전력망이다.
AI 데이터센터는 필요한 전력 규모가 큰 데다 특정 지역에 집중되는 특성이 있다.
IEA도 데이터센터의 전력 수요는 특정 지역에 집중되기 때문에 전체 전력 소비 비중만으로는 실제 전력망에 미치는 부담을 설명하기 어렵다고 지적한다.
미국에서 이 문제가 특히 선명하게 나타나는 곳 중 하나가 PJM 지역이다.
PJM은 미국 최대 전력망 운영기관으로 약 6,700만 명에게 전력을 공급한다.
2026년 상반기 기준, PJM의 송전 혼잡 비용은 약 60억 달러로 전년 동기보다 43% 증가했다. 고압 송전선의 과부하와 기상 요인 등이 직접적인 원인이었고, 데이터센터·전기차·전기 난방 등의 전력 수요 증가 역시 전력망 부담을 키우는 배경으로 지목됐다.
발전소를 더 짓는다고 곧바로 해결되는 것도 아니다.
PJM에는 대규모 발전 프로젝트가 대기하고 있지만 인허가, 송전망 건설, 공급망 등의 문제로 실제 가동 시점이 늦어지고 있다.
결국 AI 데이터센터를 짓는 속도와 그 데이터센터에 전기를 공급할 발전·송전·변전 설비를 만드는 속도가 맞지 않는 것이다.
전 세계 데이터센터 전력은 2030년 두 배 이상으로 늘어난다
수요 전망을 보면 왜 이 문제가 단기간에 끝나기 어려운지 알 수 있다.
IEA의 기본 시나리오에서 전 세계 데이터센터 전력 소비는
2024년 약 415TWh → 2030년 약 945TWh
로 증가한다.
두 배 이상이다.
2030년의 데이터센터 전력 소비량은 현재 일본 전체의 연간 전력 소비량보다 조금 많은 수준이다. AI가 이 증가를 이끄는 가장 중요한 요인으로 지목된다.
미국의 변화는 더 크다.
IEA는 2030년까지 미국에서 데이터센터가 전체 전력 수요 증가분의 거의 절반을 차지할 것으로 전망한다.
EPRI의 2026년 전망은 불확실성을 시나리오로 보여준다.
EPRI는 미국 데이터센터가 현재 미국 전체 전력 소비의 약 4~5%를 차지하지만, 2030년에는 9~17%까지 높아질 가능성을 제시한다.
이것은 단순히 발전소를 더 지으면 된다는 문제가 아니다.
데이터센터는 특정 지역에 몰린다.
따라서 전국 발전량이 충분하더라도 데이터센터가 위치한 지역의 송전망과 변전소가 그 전력을 전달하지 못하면 실제 시설은 가동할 수 없다.
전력량의 문제가 동시에 전력망의 위치 문제인 것이다.
한국은 이미 이 문제에 부딪히고 있다
한국에서는 이 문제가 더 압축된 형태로 나타난다.
2024년 8월부터 2026년 3월까지 데이터센터 1차 기술검토 신청은 총 736건이었다.
이 가운데 522건, 약 71%가 수도권에 집중됐다.
문제는 심사 결과다.
수도권 1차 기술검토에서는 279건이 공급불가 판정을 받았다.
본심사까지 올라간 수도권 데이터센터는 24건이었지만, 이 가운데 실제 통과한 것은 10건뿐이었다.
탈락률로 보면 **58.3%**다.
특히 서울에서 통과한 사례는 단 1건이었다.
반면 비수도권은 상황이 달랐다.
본심사에 올라간 29건 가운데 26건이 통과해 89.7%의 통과율을 기록했다.
숫자가 보여주는 구조는 명확하다.
데이터센터 수요는 수도권에 몰리는데, 실제 전력을 공급하기 쉬운 곳은 수도권 밖에 더 많다.
그렇다고 데이터센터를 모두 지방으로 옮기는 것도 간단하지 않다.
대규모 AI 모델을 학습시키는 데이터센터는 전력과 부지가 중요하지만, 실제 서비스를 제공하는 추론 인프라는 이용자와 가까울수록 네트워크 지연시간 측면에서 유리할 수 있다.
국내 기업과 클라우드 고객이 수도권에 집중돼 있다는 점 역시 입지 결정에 영향을 미친다.
결국 한국에서는
수요가 있는 곳과 전력을 공급하기 쉬운 곳이 서로 다르다.
AI 인프라 확대 과정에서 해결해야 할 구조적인 문제다.
승인을 받아도 변압기가 없으면 데이터센터를 켤 수 없다
전력망 문제는 발전량이나 송전선만으로 끝나지 않는다.
데이터센터에 실제로 전기를 공급하려면 변전소에서 전압을 바꿔주는 변압기(transformer)가 필요하다.
그런데 최근에는 이 장비 자체가 새로운 병목으로 떠올랐다.
Wood Mackenzie는 미국에서 전력 수요 증가와 노후 인프라 교체, 신규 발전·데이터센터 투자가 동시에 진행되면서 변압기 공급 부족이 심화되고 있다고 분석한다.
미국 전력용 변압기 공급의 상당 부분을 수입에 의존하고 있는 데다 생산능력을 단기간에 크게 늘리기도 어렵다.
납기도 빠르게 길어지고 있다.
Wood Mackenzie에 따르면 변압기 평균 리드타임은 2021년 약 50주에서 2024년 약 120주까지 늘어났다.
그리고 2026년에는 일부 변전소용 변압기의 리드타임이 160주를 넘어선 것으로 분석됐다.
3년이 넘는 시간이다.
일부 고압 전력장비는 최대 4년 수준의 납기가 필요한 경우도 있다.
수요는 반대로 빠르게 늘고 있다.
Wood Mackenzie는 미국 데이터센터 용량이 2026년 약 24GW에서 2030년 약 110GW로 증가할 것으로 전망한다. 이 증가분은 같은 기간 미국 전체 신규 전력 부하 증가의 약 **68%**에 해당한다.
수요는 몇 년 사이 몇 배로 늘어나는데, 이를 받쳐줄 변압기와 고압 전력장비는 몇 년씩 기다려야 하는 구조다.
이것이 중요한 이유는 병목의 위치 때문이다.
부지와 자금을 확보하고 계통 연계 절차까지 진행해도 필요한 변압기가 제때 도착하지 않으면 데이터센터는 전기를 받을 수 없다.
칩과 서버는 준비됐는데 전력설비 납기를 기다려야 하는 것이다.
AI 반도체는 몇 년 단위로 세대가 바뀌지만 변압기 하나를 공급받는 데만 3년 이상이 걸릴 수 있다.
AI 산업과 전력 인프라의 속도 차이가 가장 구체적으로 드러나는 지점이다.
그래서 이게 왜 반도체 이야기인가
여기까지 읽으면 전력 산업 이야기처럼 보일 수 있다.
하지만 이 문제는 결국 다시 반도체 산업으로 돌아온다.
첫째, 전력이 AI 칩 설치 속도의 상한선이 된다
GPU 생산량이 늘어도 데이터센터가 필요한 전력을 확보하지 못하면 설치 속도는 제한된다.
그리고 그 영향은 GPU에서 끝나지 않는다.
AI 가속기와 함께 들어가는 HBM, 네트워크 반도체, 광통신 부품과 전력반도체 역시 같은 데이터센터 투자 사이클에 연결돼 있다.
따라서 앞으로 AI 반도체 수요를 볼 때는 칩 공급능력뿐 아니라 실제 데이터센터의 전력 확보와 가동 시점도 함께 봐야 한다.
둘째, 전력반도체가 새로운 성장 축이 된다
랙 전력이 높아지고 800V 직류 배전 같은 새로운 구조가 확산되면 고효율 전력변환 기술의 중요성도 커진다.
SiC와 GaN 같은 와이드밴드갭 반도체, 고효율 컨버터와 전력관리 반도체가 AI 인프라 투자와 직접 연결될 가능성이 커지는 이유다.
AI 데이터센터 한 곳을 만드는 데 필요한 반도체의 범위가 넓어지고 있다.
셋째, 칩 설계의 목표가 달라진다
전력이 희소해질수록 절대 성능만 높이는 것으로는 부족하다.
중요해지는 것은 와트당 성능(performance per watt)이다.
이 관점에서 보면 최근 케코노와이즈에서 다룬 기술들도 다르게 읽힌다.
HBM은 메모리를 연산장치 가까이에 배치해 대량의 데이터를 효율적으로 공급한다.
CPO는 전기 신호가 담당하던 데이터 이동 일부를 광으로 바꿔 연결 과정의 전력 부담을 낮추려 한다.
칩렛과 UCIe는 하나의 거대한 칩 대신 여러 다이를 연결하면서 발생하는 전력·대역폭·지연 문제를 다룬다.
하이브리드 본딩 역시 더 미세한 접합을 통해 연결 밀도와 에너지 효율을 높이려는 방향과 맞닿아 있다.
결국 최근의 AI 반도체 기술 경쟁은 서로 다른 문제를 풀고 있는 것처럼 보이지만 한 가지 공통점이 있다.
데이터를 이동시키고 연산하는 데 필요한 에너지를 얼마나 줄일 것인가.
Keconowise View
이번 글에서 확인한 것을 한 문장으로 정리하면 이렇다.
AI 반도체의 성장 속도는 이제 칩의 발전 속도만으로 결정되지 않는다. 전력망과 데이터센터 인프라가 그 속도의 상한선을 만들기 시작했다.
지난 며칠 케코노와이즈에서 다룬 흐름을 이어보면 구조가 보인다.
연산 성능을 높였더니 메모리가 병목이 됐다.
HBM으로 데이터 통로를 넓히자 이번에는 칩과 칩, 서버와 서버 사이의 연결이 중요해졌다.
첨단 패키징과 하이브리드 본딩, CPO, 칩렛과 UCIe는 이 연결 문제를 해결하기 위해 등장했다.
그리고 이제 이 모든 기술을 담은 랙에 전기를 넣고 열을 빼는 단계에서 또 다른 병목이 나타나고 있다.
병목은 사라지지 않는다. 한 단계 밖으로 이동할 뿐이다.
여기에 앞선 글에서 확인했던 또 하나의 원칙이 겹친다.
기술이 발전하는 속도와 실제 인프라가 구축되는 속도는 다르다.
칩은 몇 년마다 세대가 바뀐다.
GPU 한 세대가 바뀌는 사이 랙 전력 밀도도 빠르게 높아진다.
그러나 발전소와 송전선, 변전소는 같은 속도로 늘어날 수 없다.
IEA 역시 데이터센터는 2~3년 안에도 구축할 수 있지만 더 넓은 에너지 시스템은 훨씬 긴 계획과 건설 시간이 필요하다고 지적한다.
여기에 변압기 공급 부족까지 겹친다.
132kW급 랙에서 1MW급 랙으로 넘어가는 시간보다, 변압기를 주문해 공급받는 시간이 더 길어질 수도 있다.
속도가 다른 두 산업이 하나의 AI 시스템 안에서 만나고 있는 셈이다.
그래서 앞으로 AI 반도체 뉴스를 볼 때는 질문을 하나 더 해야 한다.
새로운 GPU가 얼마나 빠른가.
HBM 대역폭이 얼마나 넓어졌는가.
패키징 기술이 얼마나 미세해졌는가.
그리고 마지막으로,
그 칩이 들어갈 데이터센터에 필요한 전력은 실제로 준비돼 있는가.
한국은 이 질문에서 특히 중요한 시험대에 올라 있다.
세계 최고 수준의 메모리 반도체 공급망을 갖고 있어도 이를 활용하는 AI 인프라의 전력망이 따라가지 못하면 반도체 경쟁력과 AI 인프라 경쟁력 사이에는 간극이 생길 수 있다.
AI 반도체 경쟁의 다음 라운드는 팹 안에서만 벌어지지 않는다.
그 경쟁은 이미 변전소와 전력망까지 확장되고 있다.